現代のデータパイプラインの構成: 5 つの役割
最終更新日: 2026年9月12日
このドキュメントの位置付け
Kafka、Spark、Airflow、Flink の役割と、パイプラインの構成要素間の契約を理解します。
ソース、取り込み、ストレージ、処理、利用は概念上の役割です。製品が必ず 1 つの役割だけを担う必要はなく、すべてのパイプラインで処理前に保存する必要もありません。ストリームは保存前に処理でき、データウェアハウス内で変換を実行することもできます。まずスキーマ、鮮度、保持期間、再処理、出力重複の扱いに関する契約を定義してください。
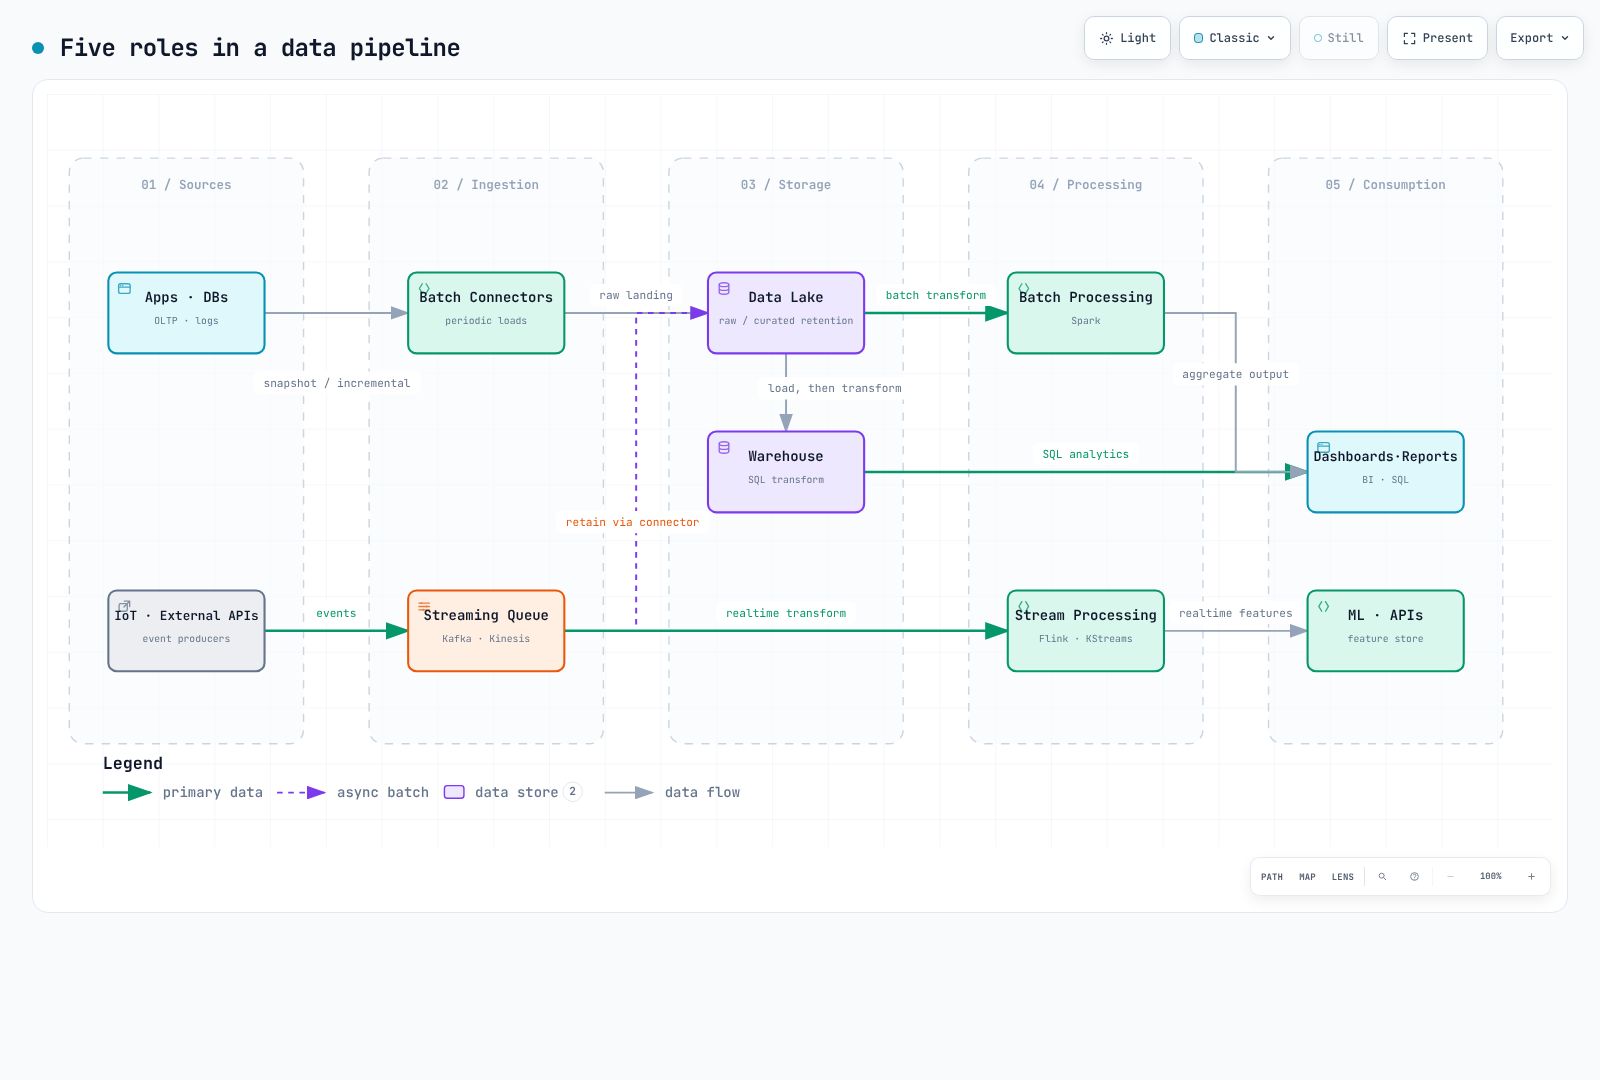
1. ソース: 変更と負荷
ソースには、アプリケーションデータベース、ログ、IoT デバイス、外部 API があります。必要に応じて、全量スナップショット、増分クエリ、ログベースの CDC を選択してください。ログベースの CDC は、データベースのレプリケーションログ、保持期間、権限に依存します。スキーマ変更への対応はコネクターと形式によって異なります。
リードレプリカやログベースの抽出によって、本番データベースの負荷を抑えられる場合があります。すべてのデータベース/コネクターの組み合わせでサポートされるわけではありません。初回スナップショットの負荷、レプリケーションラグ、ログ欠落後の復旧を確認してください。
2. 取り込み: バッチとイベント
| モード | 動作 | 例 | レイテンシの要因 |
|---|---|---|---|
| バッチ取り込み | スケジュールまたは条件に応じて、データのまとまりを抽出/ロード | Airbyte、JDBC バッチジョブ | スケジュール、データ量、宛先 |
| イベント取り込み | 変更/イベントを継続的に発行して消費 | Kafka、Kinesis、Pulsar | プロデューサー、転送、コンシューマー、シンクの遅延 |
Apache Sqoop は 2021年6月に廃止されたため、新規導入の例にはなりません。バッチ取り込みとストリーミング取り込みは、個別にも組み合わせても使えます。
Kafka のオフセットで再生できるのは、まだ存在しているレコードです。時間/サイズによる保持、ログコンパクション、tombstone ポリシーによって、過去のイベントが削除される場合があります。保持期間の設定だけでは、イベント履歴全体が揃っているとは限りません。
再生だけでは、エンドツーエンドでの exactly-once 動作は実現しません。ソース位置と処理状態は一貫して復旧する必要があり、シンクのトランザクション、冪等性、外部への副作用も同じ契約に従う必要があります。障害後にレコードを再実行することと、最終的な効果を 2 回適用することは異なります。
Kafka の運用に関する 8 つの章とパート 9 のベンチマークで、EKS での選択肢を説明しています。
3. ストレージ: 元データとクエリモデル
| 選択肢 | 例 | 設計上の考慮事項 |
|---|---|---|
| データレイク | S3 のファイル/オブジェクト | 生データと加工済みデータ、保持期間、アクセス、品質、クエリコスト |
| データウェアハウス | Redshift、Snowflake、BigQuery | データロードと SQL 変換、テーブル、性能、ガバナンス |
| レイクハウス | Iceberg、Delta Lake、Hudi | 形式/エンジンの互換性、並行性、メンテナンス |
再生のためにデータレイクへ生データを保持するのは有用ですが、唯一の標準的な経路ではありません。再処理には、実際に保持されたデータとアクセス権限が必要です。
ETL はデータを抽出し、変換してから宛先へロードします。ELT はデータを抽出して宛先へロードし、宛先内で変換します。加工済みの結果をデータウェアハウスに移しただけでは、ウェアハウスを使っているという理由で ELT になるわけではありません。データレイクとウェアハウスを両方使っても、変換の順序は決まりません。
4. 処理: 有界入力と連続入力
Spark はバッチ処理と Structured Streaming をサポートし、Flink もストリームと有界入力を処理します。バッチ/ストリームという分類によって、製品の役割が相互排他的に決まるわけではありません。
設計例として、まず暫定的なストリーム結果をすばやく出し、遅着データで修正する方法や、決済処理向けにバッチで再計算する方法があります。ストリーミングが本質的に近似値であるわけでも、バッチが本質的に厳密な値であるわけでもありません。イベント時刻、ウォーターマーク、許容遅延、重複排除、状態/チェックポイント、出力契約によって結果が決まります。
エンジンの運用については Spark ガイドと Flink ガイドを参照してください。
5. 利用: 結果の契約
BI、レポート、ML の特徴量ストア、データ API が結果を利用します。「ダッシュボードの遅延は 5 分」「締め後に決済を修正」「推奨システムの特徴量目標は 1 秒」といった要件を、測定可能な契約に置き換えてください。これらの数値は例であり、製品の性能を保証するものではありません。
複数領域にまたがる運用
- オーケストレーション: Airflow などのツールは、バッチ処理の依存関係、スケジュール、再試行を管理します。すべてのストリーミングイベントを処理するエンジンではなく、パイプラインが 2 つあるからといって Airflow が自動的に必要になるわけでもありません。
- スキーマ契約: レジストリの互換性は、検査を適用した登録、シリアライズ、CI の各経路で有効になります。ソースデータベースの DDL やビジネス上の意味の変更を自動的にすべて阻止するわけではありません。互換性ポリシーを実際のコンシューマーテストと組み合わせてください。
- オブザーバビリティ: データリネージ、鮮度、欠落/重複データ、品質メトリクス、復旧履歴を調べます。
EKS の視点で見る
Kafka、Spark、Flink は、それぞれの Operator/デプロイモデルを使います。Airflow は Helm、エグゼキューター、KubernetesPodOperator などのタスク Operator を使用します。Airflow の「Operator」と Kubernetes コントローラーは、同じ概念ではありません。ストレージ、分析、マネージドワークスペースは、外部の AWS サービスで実行できます。マネージド型の代替手段と責任範囲を比較してください。
参考資料
概念を図で示したものは Abhishek Agrawal の「Anatomy of a Modern Data Pipeline」インフォグラフィックから始まり、契約と運用ガイダンスは別途レビューしています。