第 3 部分:Amazon EMR on EKS
最后审查:2026 年 10 月 16 日 · API 示例:
emr-spark-8.0.0-20260421
运行时和提交路径
EMR on EKS 会向现有 EKS 基础设施提供由 AWS 策划的 Spark 运行时和提交服务。EKS 容量、网络、存储和节点仍由你运维。请区分以下路径:
| 路径 | 提交方式和生命周期 | 由你管理的内容 |
|---|---|---|
| StartJobRun | 使用 EMR virtual cluster ID 和执行角色调用 AWS API | EMR 作业状态、权限和日志配置 |
| EMR 运行时 + Spark Operator | 向已安装的 EMR Operator 提交 SparkApplication CR | Helm / CRD、controller、Kubernetes RBAC 和 CR 生命周期 |
| 直接 spark-submit | Spark 向 Kubernetes API 提交 | 提交方、Spark 配置、状态和重跑 |
自 EMR 6.10.0 起支持 Spark Operator,并不意味着 StartJobRun 可以选择在内部委派给该 Operator。文档说明的 Operator 路径需单独安装,并使用 kubectl apply。不要假设这些 CR 应用会自动获得 StartJobRun ID,或由 EMR 作业 API 管理。可以将 EMR 运行时与基于 CR 的操作结合使用,但提交、观测和重试由所选路径决定。EMR chart 也不同于第 2 部分介绍的当前上游 chart。
当前发行版本和可复现性
| EMR on EKS 发行版本 | Spark 运行时 |
|---|---|
| emr-7.14.0 | 3.5.8-amzn-0 |
| emr-spark-8.1.0 | 4.1.1-amzn-0;LTS,于 2026 年 9 月发布 |
| emr-spark-8.0.0 | 4.0.2-amzn-0;Spark 4.x GA,于 2026 年 5 月发布 |
Spark 4 已可用。8.0.0 指的是 EMR 运行时发行版本,不是 Apache Spark 8。对于其他 EMR 部署选项,应分别核查其版本和功能。-latest 别名会随安全更新而变化,并不固定到完全相同的镜像字节。带日期的后缀有助于复现,但仍需审查更新。下面的带日期示例是可复现基线,并不表示它包含最新安全补丁。
准备环境
使用受支持的 EKS 发行版本、兼容的 kubectl 和当前 AWS CLI v2,不要采用过时且笼统推荐 Kubernetes 1.30 的做法。Pod Identity CLI helper 需要 2.24.0 或更高版本。请让管理员准备:
emr-spark命名空间、节点容量 / 网络、配额和准入策略。- EMR 服务关联角色和 EKS API 访问权限。对于新的 virtual cluster,使用 Access Entry 集成。文档中的 CAM 流程以 API_AND_CONFIG_MAP 为例;应检查当前模式,不要试图将 API-only 集群降级。现有 virtual cluster 不会自动迁移。
docs-emr-job执行角色:读取下方脚本对象,并只授予所需的数据 / KMS 以及 CloudWatch 日志组 / 日志流权限。- 一个已有的 S3 制品 bucket 和应用了保留策略的
/emr-containers/docs-spark日志组。上传者和作业执行方的权限是分开的。 - 调用方启动、查看和取消作业,并使用允许的执行角色所需的权限。使用
emr-containers:ExecutionRoleArn限制角色。对于 Pod Identity,将 PassRole 权限限定到选定角色和pods.eks.amazonaws.com。
Virtual cluster 会注册 EKS 命名空间,不会创建计算容量。不过,注册可能会创建初始服务关联角色,并配置 CAM access entry / policy。声称“注册不会更改资源或权限”过于宽泛。命名空间还需要 RBAC、网络和 Pod 安全控制,才能实现隔离。
执行角色:IRSA 或 Pod Identity
IRSA 需要集群的 IAM OIDC provider,以及范围限定到 audience、命名空间和 EMR 管理的 service account 身份的信任策略。update-role-trust-policy 会修改此信任关系,但不会授予数据权限或调用方权限。
StartJobRun 从 EMR 7.3.0 起也支持 EKS Pod Identity。应准备 Agent、节点 EKS Auth 权限、针对 pods.eks.amazonaws.com 的 sts:AssumeRole / sts:TagSession 信任,以及 EMR service account 关联。helper 会为 submitter、driver 和 executor 准备三个关联。IRSA 注解不能取代这些关联。
替换集群 / 角色 / 命名空间值,并且只执行选定的路径。这些 helper 会修改 IAM / EKS 配置。
# Option A: IRSA, after creating the cluster IAM OIDC provider and job role.
aws emr-containers update-role-trust-policy \
  --region "$AWS_REGION" \
  --cluster-name my-eks-cluster --namespace emr-spark --role-name docs-emr-job

# Option B: Pod Identity, after configuring the agent/node permissions and job-role trust.
# Choose the appropriate path; these are not two mandatory consecutive steps.
aws emr-containers create-role-associations \
  --region "$AWS_REGION" \
  --cluster-name my-eks-cluster --namespace emr-spark --role-name docs-emr-job
注册 virtual cluster
另存为 create-virtual-cluster.json,并替换示例名称。
{
  "name": "docs-spark-vc",
  "containerProvider": {
    "id": "my-eks-cluster",
    "type": "EKS",
    "info": {
      "eksInfo": {
        "namespace": "emr-spark"
      }
    }
  }
}
当前服务文档还定义了 schedulerConfiguration,以及 maxConcurrentJobRuns 和 maxInQueueJobRuns。用于本次审查的 AWS CLI 2.35.11 服务模型缺少此字段,因此未将其纳入基线示例。使用前请验证 CLI / SDK 是否支持。作业数量限制不能取代 CPU / 内存配额或 executor 上限。
# Replace the cluster/name/namespace in create-virtual-cluster.json first.
: "${AWS_REGION:?Set the region of the EKS cluster}"
aws emr-containers create-virtual-cluster \
  --region "$AWS_REGION" \
  --cli-input-json file://create-virtual-cluster.json \
  --query id --output text
# Copy the returned id into start-job-run.json; verify state before submitting.
: "${EMR_VIRTUAL_CLUSTER_ID:?Set the returned virtual cluster ID}"
aws emr-containers describe-virtual-cluster \
  --region "$AWS_REGION" --id "$EMR_VIRTUAL_CLUSTER_ID" \
  --query 'virtualCluster.{state:state,provider:containerProvider}'
CreateVirtualCluster 会返回 id。将其作为 StartJobRun 的 virtualClusterId 使用,并验证状态为 RUNNING 且目标命名空间正确。
提交冒烟作业
另存为 smoke.py。该脚本会检查 rows=10 和 total=45,不会修改外部数据集。
from pyspark.sql import SparkSession
from pyspark.sql import functions as F

spark = SparkSession.builder.appName("docs-emr-smoke").getOrCreate()
try:
    result = spark.range(10).agg(F.count("*").alias("rows"), F.sum("id").alias("total")).first()
    if result.rows != 10 or result.total != 45:
        raise RuntimeError(f"Unexpected result: {result}")
    print("SMOKE_OK rows=10 total=45")
finally:
    spark.stop()
另存为 start-job-run.json,并替换 virtualClusterId、账户、角色和 bucket。提交前应准备脚本读取权限和日志组访问权限。
{
  "name": "docs-spark-smoke",
  "virtualClusterId": "abcd1234efgh5678ijkl9012mnop",
  "executionRoleArn": "arn:aws:iam::111122223333:role/docs-emr-job",
  "releaseLabel": "emr-spark-8.0.0-20260421",
  "jobDriver": {
    "sparkSubmitJobDriver": {
      "entryPoint": "s3://my-existing-artifact-bucket/docs-emr/smoke.py",
      "sparkSubmitParameters": "--conf spark.executor.instances=2 --conf spark.executor.cores=1 --conf spark.executor.memory=1g --conf spark.driver.cores=1 --conf spark.driver.memory=1g"
    }
  },
  "configurationOverrides": {
    "monitoringConfiguration": {
      "cloudWatchMonitoringConfiguration": {
        "logGroupName": "/emr-containers/docs-spark",
        "logStreamNamePrefix": "smoke"
      }
    }
  }
}# Replace the bucket in this command and start-job-run.json with the same existing bucket.
aws s3 cp smoke.py s3://my-existing-artifact-bucket/docs-emr/smoke.py \
--region "$AWS_REGION"
# Keep this token for retries of the same request. Use a new token for a new intended run.
EMR_REQUEST_TOKEN="$(python3 -c 'import uuid; print(uuid.uuid4())')"
aws emr-containers start-job-run \
--region "$AWS_REGION" \
--cli-input-json file://start-job-run.json \
--client-token "$EMR_REQUEST_TOKEN" --query id --output text
: "${EMR_JOB_ID:?Set the returned job ID}"
aws emr-containers describe-job-run \
--region "$AWS_REGION" --virtual-cluster-id "$EMR_VIRTUAL_CLUSTER_ID" \
--id "$EMR_JOB_ID" --query 'jobRun.{state:state,details:stateDetails,reason:failureReason}'API 接受请求并不表示作业已完成。应检查最终状态为 COMPLETED,并在 driver 日志中确认 SMOKE_OK rows=10 total=45。请求令牌可去重 API 请求;它不能保证应用重试期间的外部副作用恰好发生一次。失败时检查 stateDetails、failureReason 以及 submitter / driver / executor 日志。
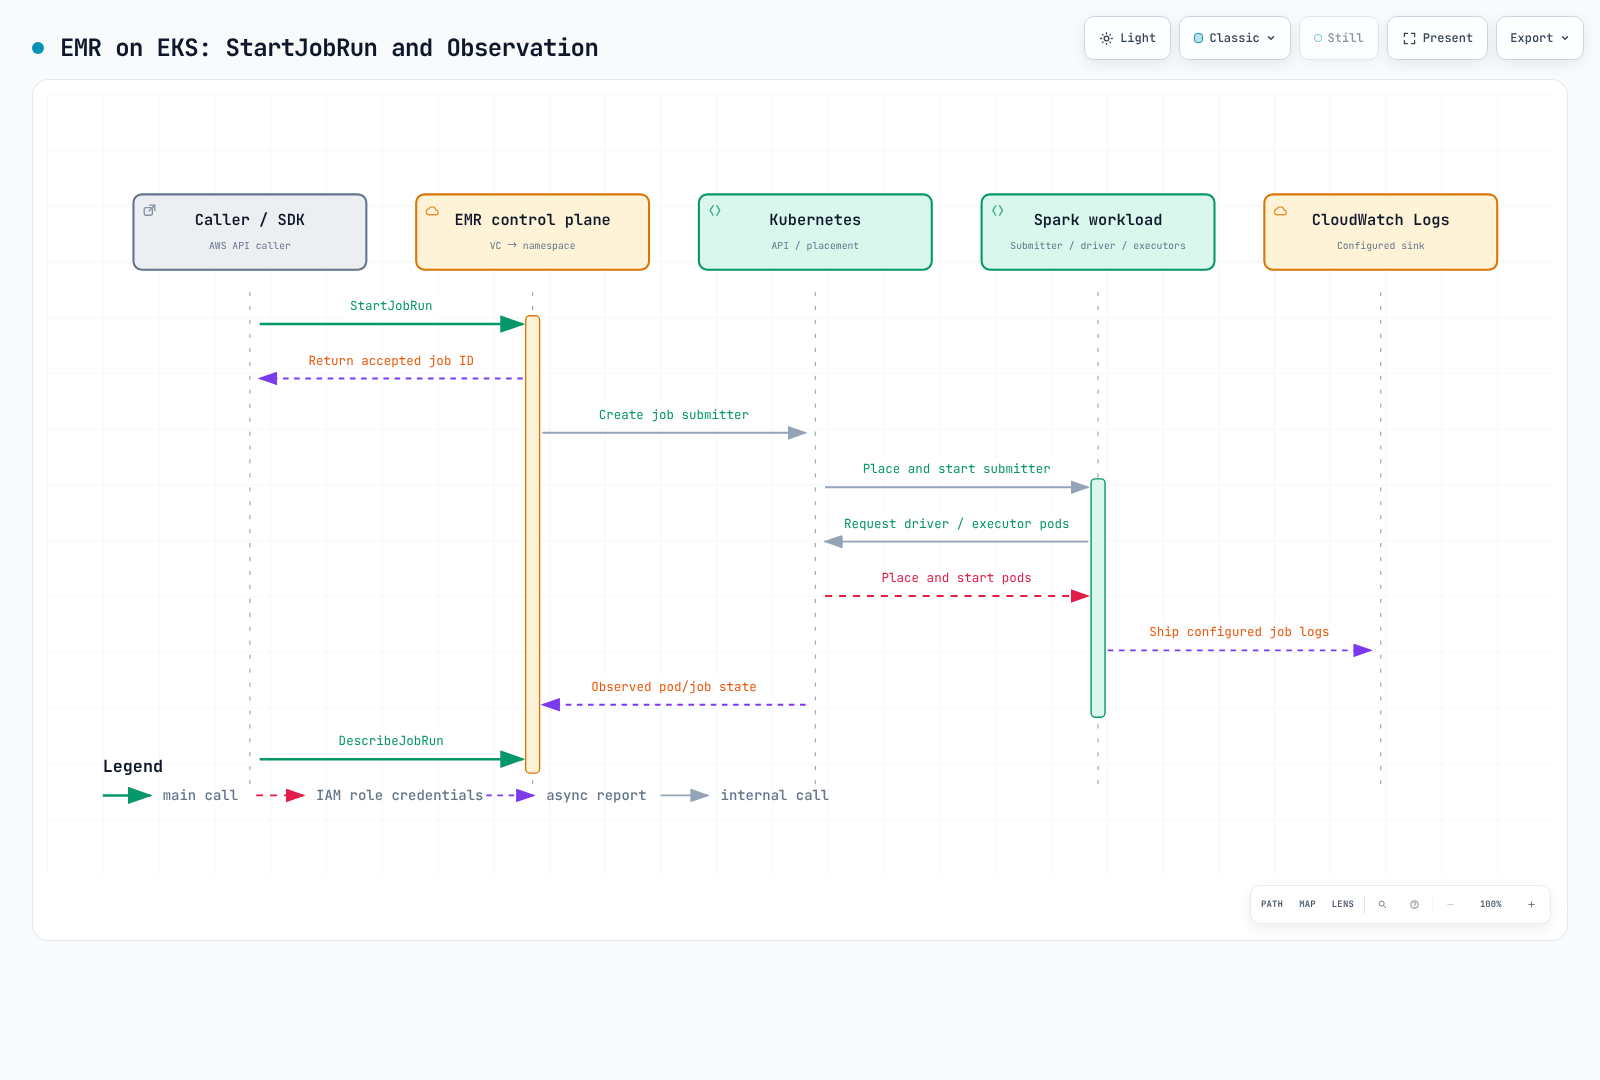
Pod 配置、观测和交互式开发
可使用 kubectl 在命名空间中查看 EMR Pod。支持 Pod template 和自定义镜像路径,因此“不能编写 Pod 配置”是不正确的。不要随意覆盖 StartJobRun 管理的命名空间、service account 或 Pod 名称设置。请遵循特定发行版 / 提交方式支持的字段和自定义镜像验证流程。
CloudWatch 日志需要配置 monitoringConfiguration 和执行角色权限。应区分作业状态指标与完整的 Spark executor 遥测。Step Functions 支持 StartJobRun 请求 / 响应和 .sync 集成,但需要配置状态机和角色。EventBridge 作业事件也需要规则、目标和故障处理。某项集成可用,并不代表所有采集或自动化都已启用。
EMR Studio 会连接到通过 CreateManagedEndpoint 创建的交互式端点。Jupyter Enterprise Gateway 管理 kernel 生命周期,并需要私有子网、ALB controller、网络和角色等前提条件。Notebook 单元格并非普通的 StartJobRun 批处理调用。共享端点的用户 / kernel 会使用该端点的执行角色;应审查访问边界,并在需要时使用独立端点。端点和 kernel 会产生费用,仅注册 virtual cluster 则不会产生此类费用。
选择和清理
如果需要 AWS API 提交生命周期,可选择 StartJobRun;对于基于 CR 的操作,则评估是否适合使用 Operator。比较所需的上游版本 / 插件、可移植性、实测性能和总成本。EMR 并不会免除 EKS / 计算、存储和日志费用,也不会免除基础设施运维责任。
删除 virtual cluster 并不是清理作业、数据和角色的通用命令。应分别检查活动作业 / 端点,并单独清理预期资源。
# Inspect active work/endpoints before cleanup.
aws emr-containers list-job-runs \
  --region "$AWS_REGION" --virtual-cluster-id "$EMR_VIRTUAL_CLUSTER_ID"
aws emr-containers list-managed-endpoints \
  --region "$AWS_REGION" --virtual-cluster-id "$EMR_VIRTUAL_CLUSTER_ID"
# If this demo job is still active and should stop:
aws emr-containers cancel-job-run \
  --region "$AWS_REGION" --virtual-cluster-id "$EMR_VIRTUAL_CLUSTER_ID" --id "$EMR_JOB_ID"
# After reviewing/cleaning the relevant jobs and any managed endpoints:
aws emr-containers delete-virtual-cluster \
  --region "$AWS_REGION" --id "$EMR_VIRTUAL_CLUSTER_ID"
aws emr-containers describe-virtual-cluster \
  --region "$AWS_REGION" --id "$EMR_VIRTUAL_CLUSTER_ID" --query virtualCluster.state
应观察异步删除状态;权限失败可能导致状态变为 ARRESTED。分别检查命名空间、EKS 集群、S3 制品、日志组、IAM 角色和 Pod Identity 关联。删除命名空间 / SA 后,关联可能仍会保留;只移除不再使用的关联。不要为此演示删除共享资源。
已检查示例的本地 CLI 输入结构和语法。此过程不代表已完成 AWS 部署或 EMR 运行时测试。请在目标环境中验证权限、配额、网络和发行版本可用性。
- EMR on EKS 发行版本标签
- EMR Spark 8.0.0 on EKS 发行说明
- EKS 集群访问设置
- 作业执行角色和执行角色条件
- 为 StartJobRun 设置 Pod Identity
- Virtual cluster 和调度器限制
- StartJobRun API
- EMR Spark Operator 安装和 CR 提交
- 交互式端点架构
- 自定义镜像
- CloudWatch 日志配置