第 6 部分:分布式追踪分析
难度:高级 · 预计时间:45 分钟 最后更新:September 13, 2026
从指标出发,经由 exemplar 追踪到其 trace 和日志,跟踪一个真实请求,并区分观测结果与因果假设。这需要 第 2 部分的采集路径以及第 3 部分的上下文传播。以下 TraceQL 已使用实际 Tempo 3.0.3 解析器验证,并采用当前的 OTel 属性。
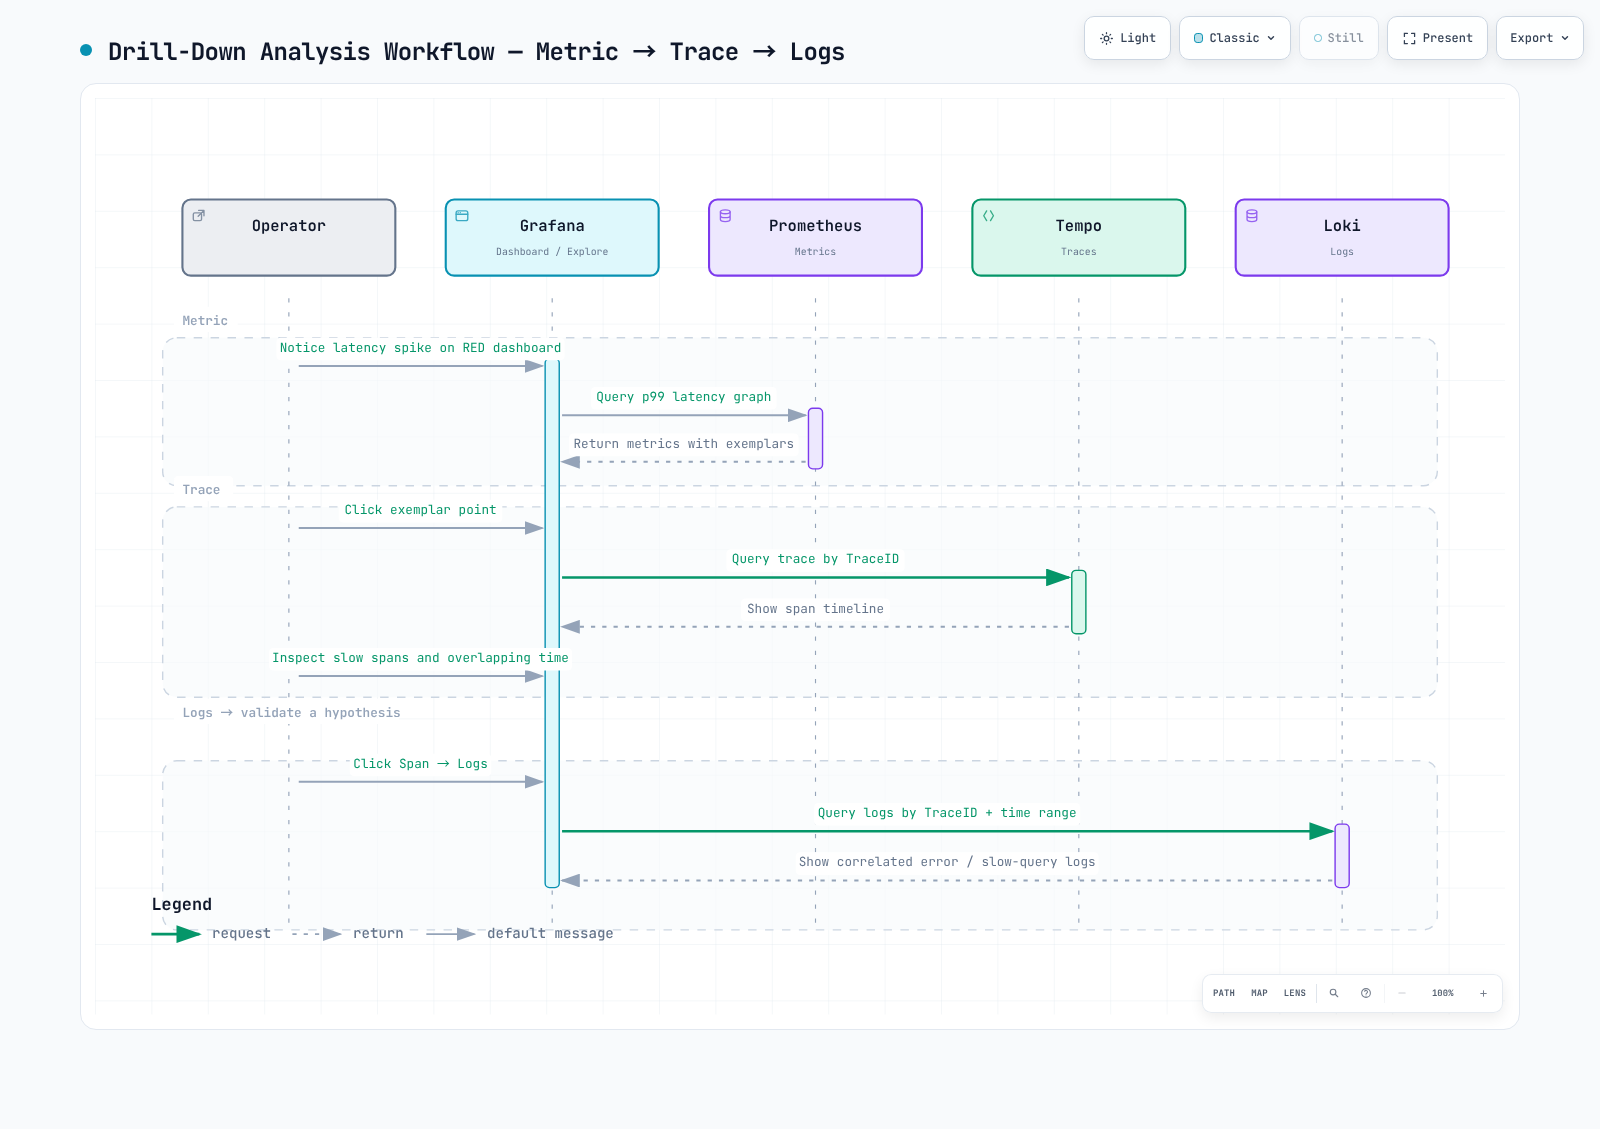
1. TraceQL 搜索
{ resource.service.name = "order-service" && span:duration > 1s }

{ trace:duration > 2s && resource.service.name = "order-service" }

{ span:kind = server && span.http.response.status_code >= 500 }

{ span.db.system.name = "postgresql" && span:duration > 100ms }

{ span.messaging.system = "aws_sqs" && span.messaging.operation.type = "send" }

{ resource.service.name = "api-gateway" } >> { resource.service.name = "order-service" }

{ resource.service.name = "order-service" } >> { span.db.system.name = "postgresql" }

{ span:status = error } | select(resource.service.name, span.http.response.status_code, span:duration)
span:duration 测量单个 span;trace:duration 测量整个 trace。对于显式内置属性使用 span:,对于属性使用 span./resource.。>> 查找从左侧 span 派生的右侧 span。查找 DB span 的后代不同于查找某个 Service 下的 DB 工作。
sort(duration)、SQL order by、| limit 20 和 { duration > p99 } 均不属于此搜索语法。请在 Grafana 中配置结果排序、搜索限制和时间范围,并将测得的 p99 替换为时长文字量,例如 800ms。select() 请求显示属性;它无法重新创建从未存储的 span。
较旧的 SDK 可能会生成 http.status_code、http.method、db.system、db.statement 或 messaging.operation。在使用当前的 http.response.status_code、http.request.method、db.system.name、db.query.text 或 messaging.operation.type 之前,请检查实际 span 和 SDK 版本。重命名查询属性不会转换已采集的数据。仅在明确的数据脱敏策略下采集查询文本;排除密码、SQL 文字量和客户数据。
2. Service graph 前提条件
仅在 Tempo 中接收 traces 并不能完成 Grafana Service graph。启用 metrics-generator 的 service-graphs processor,将其指标传递给真实的指标后端,并将 Grafana Tempo datasource 的 serviceMap UID 链接到该后端。client/server 或 producer/consumer spans 必须共享上下文。采样、缺失的 spans 和不正确的 span kind 都会影响生成的边。
sum by (client, server) (rate(traces_service_graph_request_total[5m]))

(
  sum by (client, server) (rate(traces_service_graph_request_failed_total[5m]))
  or on (client, server)
  (0 * sum by (client, server) (rate(traces_service_graph_request_total[5m])))
)
/ on (client, server)
(sum by (client, server) (rate(traces_service_graph_request_total[5m])) > 0)

sum by (client, server) (rate(traces_service_graph_request_server_seconds_sum[5m]))
/
sum by (client, server) (rate(traces_service_graph_request_server_seconds_count[5m]))
在首次失败之前,失败计数器可能没有任何 series。使用匹配的请求总数 series 以零填充其缺失的分子,然后要求分母为正,以区分健康的 0% 与无流量或缺失采集。
最后一个查询测量服务端平均时长。客户端时长使用 traces_service_graph_request_client_seconds_*;请勿查询不存在的 traces_service_graph_request_duration_seconds_* 系列。将零流量时间段视为缺失证据。颜色和边宽取决于 Grafana/dashboard 设置;请检查请求/错误/时长值,而不是假定固定的 1%/5% 颜色规则。
3. 从瀑布图形成瓶颈假设
| 观测结果 | 后续操作 |
|---|---|
| DB span 缓慢 | 检查查询计划、锁、连接池和 DB 指标 |
| client span 很长 | 比较 DNS/TLS/网络/服务器等待/重试时间段 |
| 父 span 与子 span 之间存在间隔 | 检查未插桩的工作、队列、GC 和调度 |
| 并行子 spans | 分析重叠和关键路径,而不是累加时长 |
| 消息传递延迟 | 将发送/接收/处理时长与队列等待和重新投递区分开 |
父级时长包含子级时长;将所有 spans 相加会重复计算时间。单独一个 1.8 秒的 DB span 并不能证明缺少索引。在接受某个假设之前,请比较相同发布版本、流量和时间范围内的日志与指标。
4. 链接日志和 traces
{service_name="order-service"} | json | level="ERROR"

{service_name="order-service"} | json | trace_id="0123456789abcdef0123456789abcdef"
这些查询假定实际存在 service_name stream label 和 JSON trace_id 字段。请使用真实请求 ID 替换 32 字符的示例 trace ID。traceID、traceId 和 trace_id 是不同字段。将 trace ID 保留在日志字段/结构化元数据中,而不是唯一的 stream labels 中。在 Grafana/HTTP 参数中设置时间边界;不要将 timestamp >= 2025-... 追加到 LogQL。
Loki derived field 会提取 trace ID 并链接到 Tempo datasource UID。在 Grafana provisioning YAML 中,将内部链接表达式转义为 $${__value.raw}。双引号的 regex 和范围宽泛的 shell envsubst 可能会更改反斜杠或 Grafana 变量;请使用适当的单引号和范围狭窄的替换。
使用 Loki UID、实际的 resource-to-log label 映射、时间填充以及 trace-ID 过滤配置 Tempo tracesToLogsV2。点击“Logs for this span”后检查生成的 LogQL。链接存在和成功检索同一请求是两项独立检查。
5. Exemplar 的含义和验证
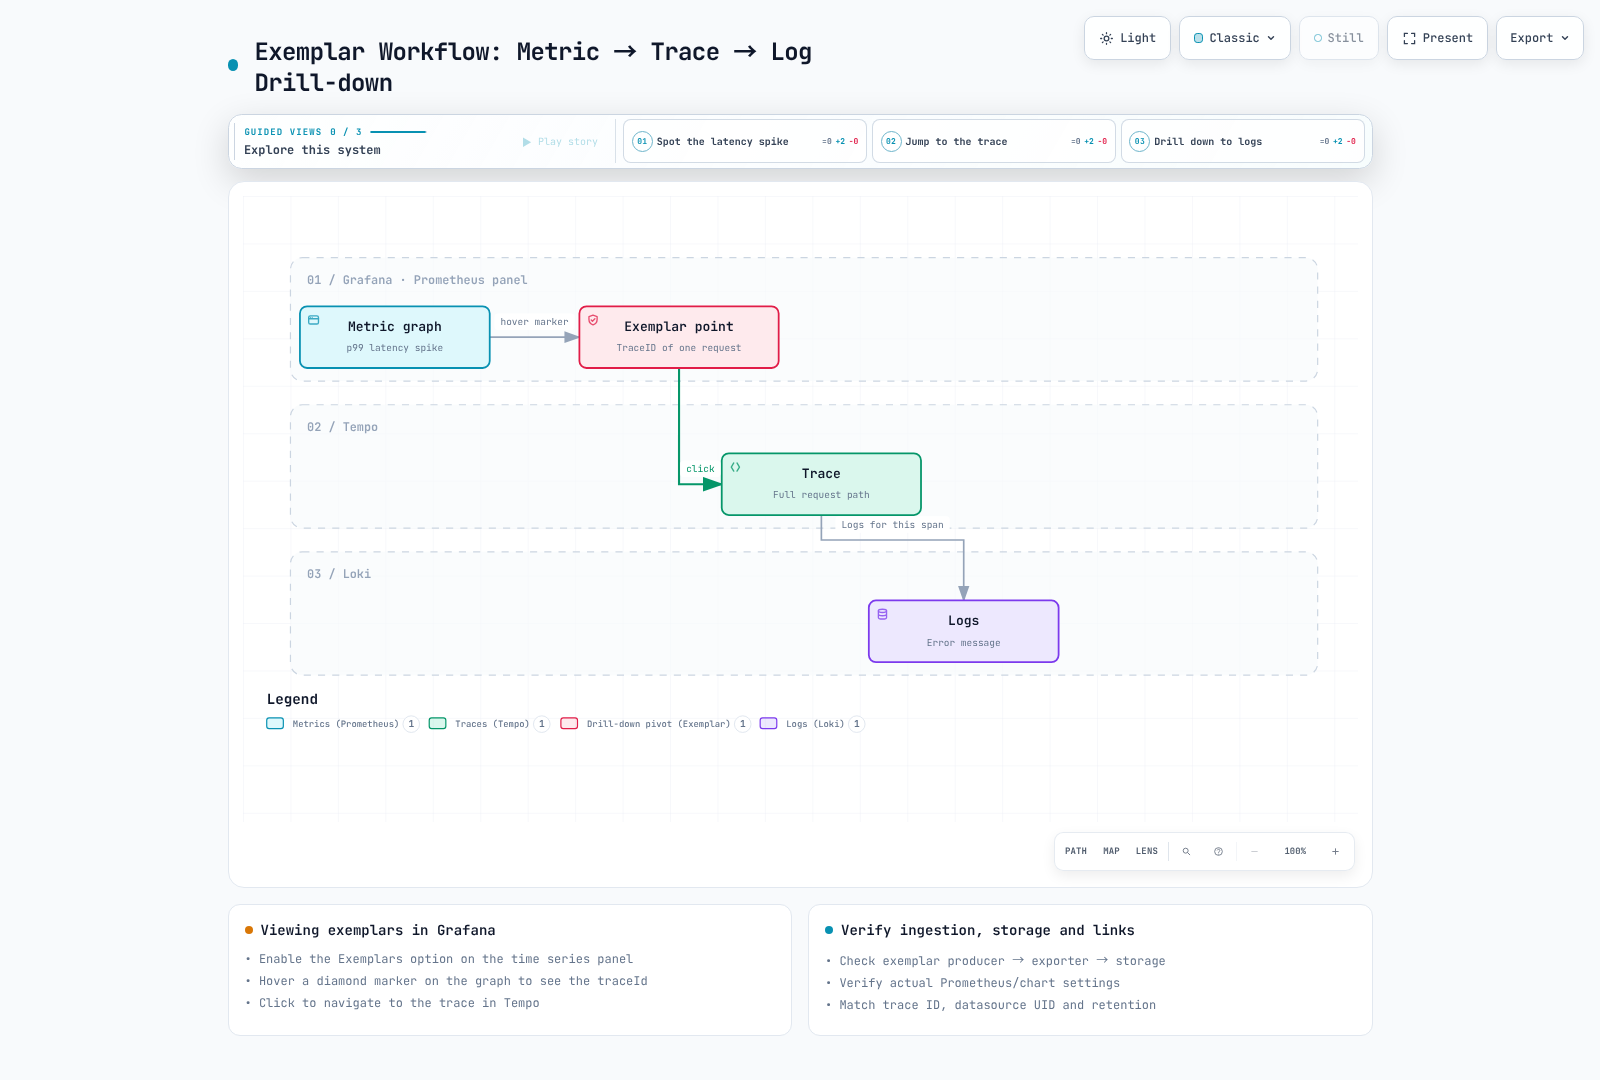
exemplar 是附加到聚合数据的代表性观测。点击 p99 图表上的一个点并不能证明该请求确定了精确的百分位边界。exemplar 生成、exporter/remote-write 保留、Prometheus 存储和 Grafana datasource 链接必须全部正常工作。采样或保留策略可能导致 exemplar ID 存在而其 trace 不可用。
检查实际的 Prometheus exemplar API 结果,并使用返回的 trace_id 查询 Tempo。启用 Grafana 显示选项或搜索不存在的 Prometheus ConfigMap 并不是采集验证。请根据已安装的 Prometheus/chart 版本以及渲染后的 Prometheus resource/runtime 参数确认 exemplar-storage 设置。
6. RED 和 SLI/SLO dashboards
基于实际的指标名称、labels 和 histogram 单位构建 RED panels。在相同的 Service/route 范围内比较请求速率、失败率和时长分布。在计算可用性之前,定义合格请求和成功;说明如何处理 4xx 响应、健康检查和重试。
30 天 SLO 需要在该时段内有真实的保留数据和观测结果。全新实验中的 [30d] 查询不会产生 30 天的证据。处理无流量、缺失 series 和计数器重置;披露低流量百分位数的局限性。使用相同时间窗口内允许的失败次数和观测到的失败次数计算错误预算。记录周期、分母和值,而不是声称固定的“已达成 99.9%”。
7. 验证流程,然后清理
清理前,记录一个 exemplar ID、Tempo trace ID 和日志 trace ID 相匹配的请求;验证实际 Service graph 依赖关系和告警投递。保留测量值、时间戳和配置版本,而不是用估算值填充结果。
| 顺序 | 操作和完成条件 |
|---|---|
| 1 | 停止 k6/Locust、故障注入和 AI 分析触发器;保存结果 |
| 2 | 停止 GitOps ApplicationSet/父级重建,并级联删除实际 application |
| 3 | 删除 service-cluster LoadBalancers/Ingresses、workloads 和 PVCs;验证外部 LB/volume 清理 |
| 4 | 在使用实际 release/namespace 名称卸载其 operators 之前,先删除 telemetry custom resources |
| 5 | 在移除 controller 之前 drain/delete Karpenter NodeClaims;在依赖项仍存在时保留 API/LB/storage controllers |
| 6 | 使用相同的 IaC state 审核 destroy plans;对手动创建的 AWS resources 使用记录的精确 IDs/ARNs |
| 7 | 在依赖项清理后删除 EKS/VPC,然后验证 managed-service 删除和残留 resources |
不要删除共享 namespace 或 cluster-wide CRDs。请使用记录的安装 release/namespace/version,而不是 latest 安装程序 URL。版本化 S3 不仅需要检查当前 objects,还需要检查旧版本和 delete markers。根据库存核对 Aurora snapshot policy、MWAA/DAG bucket、AMG、AMP、OpenSearch、SNS/SQS/DLQ、Lambda/API Gateway、IAM attachments、EBS/LBs、log groups 和 alarms。已接受的删除请求并不意味着删除已经完成。
审核 resource 所有权并保留证据/state,而不是使用未经检查且自动批准的 destroy、抑制所有错误或删除整个工作目录。
验证范围和参考资料
当前 Tempo 解析器验证了 12 个被接受的查询,并拒绝了之前三个错误查询。临时本地 Loki 3.7.7 接收了两条合成日志行;两个 LogQL 查询均检索到完全符合预期的 trace ID。未执行实际的 Service Tempo 搜索、Loki 收集、Grafana 数据链接和云删除。