集群架构
支持版本: Kubernetes 1.35, 1.36, 1.37 最后更新: October 12, 2026
版本标题指的是上游 Kubernetes。该项目为最近三个次要版本(1.35–1.37)维护发布分支。上游 1.34 处于维护模式,在 October 27, 2026 生命周期结束之前仍会接收补丁版本,这与 EKS 上的 AWS 支持结束日期不同。
截至 October 12, 2026,EKS 标准支持涵盖 1.34–1.37;EKS 1.37 于 October 1, 2026 可用。在选择版本前,请查看 Kubernetes 发布状态 和 EKS 生命周期。
以下组件命令展示自主管理的集群;EKS 管理其控制平面。镜像标签和基础设施 ID 均为示例:请选择兼容且持续维护的镜像,并在使用前替换占位符。
实验环境设置
要练习本文档中的概念,需要以下工具和环境:
必需工具
- 与 API server 相差不超过一个次要版本的 kubectl
- 一个可用的 Kubernetes 集群(EKS、minikube、kind 等)
本地开发环境设置
# Install minikube (for local development)
curl -LO https://storage.googleapis.com/minikube/releases/latest/minikube-linux-amd64
sudo install minikube-linux-amd64 /usr/local/bin/minikube

# Start cluster
minikube start

# Check cluster status
kubectl cluster-info

# Check control plane components
kubectl get pods -n kube-system
集群架构概览
核心概念: Kubernetes 集群由控制平面和工作节点组成,每一部分都包含执行特定角色的多个组件。
Kubernetes 集群由一组用于运行容器化应用程序的节点(虚拟机或物理机)组成。集群大致分为控制平面和工作节点。
集群架构图
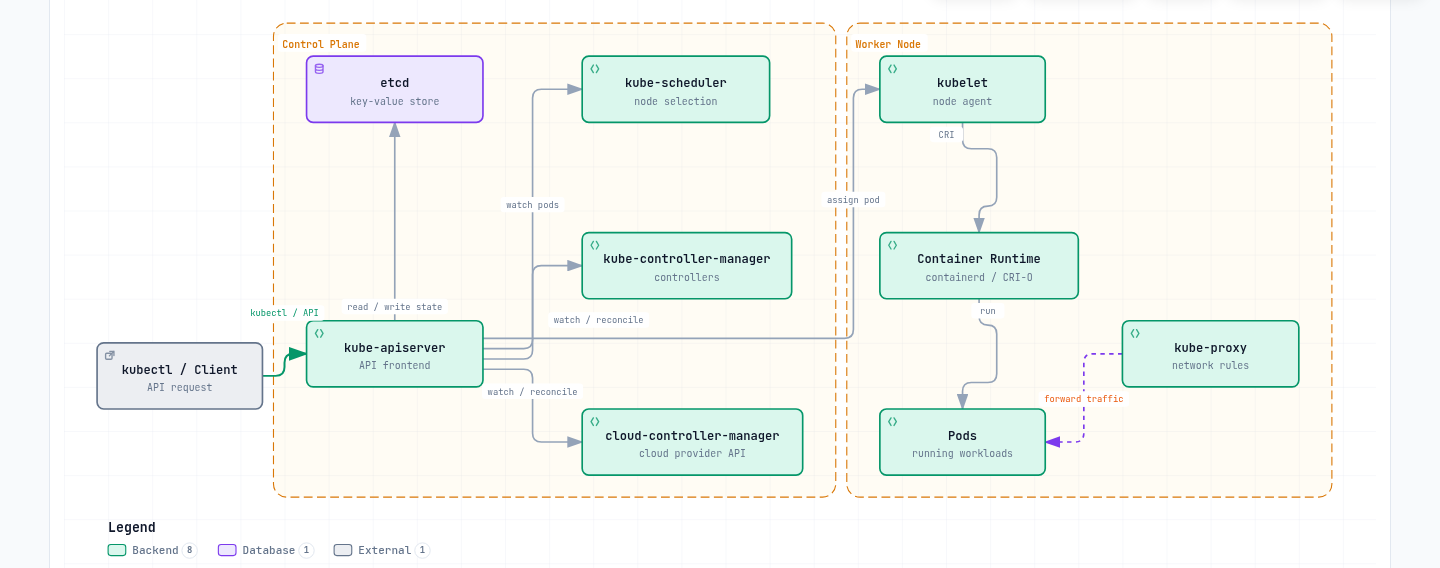
控制平面组件:
- kube-apiserver: 公开 Kubernetes API 的前端
- etcd: 存储 Kubernetes API 状态的键值存储
- kube-scheduler: 选择运行新建 Pod 的节点
- kube-controller-manager: 运行管理集群状态的控制器
- cloud-controller-manager: 与云提供商 API 交互
工作节点组件:
- kubelet: 在每个节点运行、管理容器执行的代理
- kube-proxy: 维护网络规则并执行连接转发
- Container Runtime: 运行容器(containerd、CRI-O 等)
控制平面组件
控制平面是 Kubernetes 集群的“中枢”,负责管理和控制集群的整体状态。控制平面组件通常运行在专用机器上,并可复制为多个实例以实现高可用性。
控制平面组件详情
| 组件 | 主要功能 | 通信对象 | 高可用性配置 |
|---|---|---|---|
| kube-apiserver | - 提供 Kubernetes API - 身份验证和授权 - API 请求处理 | - 所有组件 - etcd | 通过多个实例进行水平扩展 |
| etcd | - 存储集群数据 - 分布式键值存储 - 确保一致性 | - kube-apiserver | 多节点集群 |
| kube-scheduler | - Pod 放置决策 - 评估节点资源 - 应用亲和性/反亲和性 | - kube-apiserver | 主备配置 |
| kube-controller-manager | - 节点控制器 - 副本控制器 - Endpoint 控制器 - Service account 控制器 | - kube-apiserver | 主备配置 |
| cloud-controller-manager | - 云提供商集成 - 节点生命周期 - 路由与负载均衡 | - kube-apiserver - Cloud API | 主备配置 |
控制平面通信流程
- 用户或控制器向 kube-apiserver 发送请求
- kube-apiserver 执行身份验证、授权和准入
- kube-apiserver 从 etcd 读取或向其写入数据
- 控制器和 scheduler 通过 kube-apiserver 监视集群状态
- kubelet 向 kube-apiserver 报告节点状态
kube-apiserver
kube-apiserver 是公开 Kubernetes API 的控制平面前端。所有内部和外部请求都通过此 API server 处理。
主要功能:
- 提供 REST API
- 身份验证和授权
- 请求验证和处理
- 与 etcd 通信
- 可水平扩展(可扩展为多个实例)
主要标志和配置选项:
# Basic configuration example
kube-apiserver \
  --advertise-address=192.168.1.10 \
  --allow-privileged=true \
  --authorization-mode=Node,RBAC \
  --client-ca-file=/etc/kubernetes/pki/ca.crt \
  --enable-admission-plugins=NodeRestriction \
  --enable-bootstrap-token-auth=true \
  --etcd-servers=https://127.0.0.1:2379 \
  --etcd-cafile=/etc/kubernetes/pki/etcd/ca.crt \
  --etcd-certfile=/etc/kubernetes/pki/apiserver-etcd-client.crt \
  --etcd-keyfile=/etc/kubernetes/pki/apiserver-etcd-client.key \
  --kubelet-client-certificate=/etc/kubernetes/pki/apiserver-kubelet-client.crt \
  --kubelet-client-key=/etc/kubernetes/pki/apiserver-kubelet-client.key \
  --service-account-key-file=/etc/kubernetes/pki/sa.pub \
  --service-account-signing-key-file=/etc/kubernetes/pki/sa.key \
  --service-account-issuer=https://kubernetes.default.svc.cluster.local \
  --service-cluster-ip-range=10.96.0.0/12 \
  --tls-cert-file=/etc/kubernetes/pki/apiserver.crt \
  --tls-private-key-file=/etc/kubernetes/pki/apiserver.key
API Server 安全性:
- 通过 TLS 证书进行安全通信
- 支持多种身份验证方法(X.509 证书、service account token、OIDC、webhook 等)
- 通过 RBAC(基于角色的访问控制)进行权限管理
- 通过 admission controller 验证和修改请求
etcd
etcd 是一个具有一致性和高可用性的键值存储,用于保存 Kubernetes API 状态。它充当 Kubernetes 的“事实来源”。
主要特性:
- 分布式系统
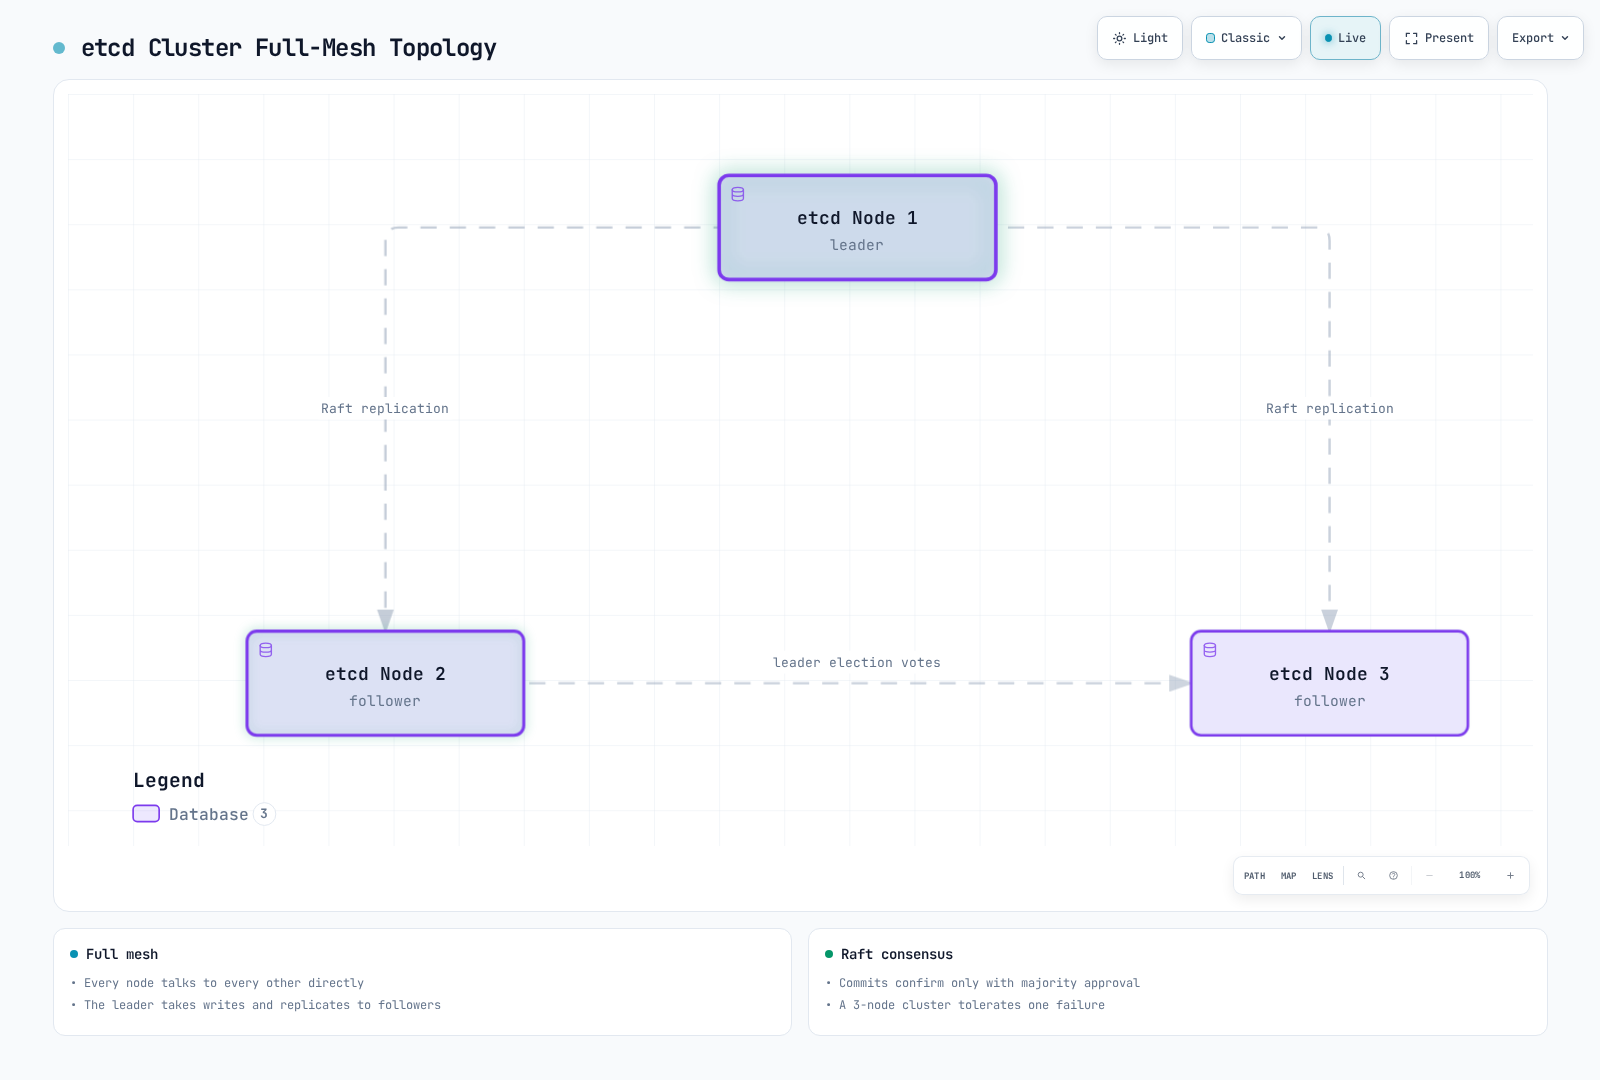
- 强一致性(使用 Raft 共识算法)
- 高可用性(可配置多个节点)
- 安全的数据存储
- 用于监视变更的 watch 功能
etcd 集群配置:
# etcd cluster configuration example (3 nodes)
etcd \
  --name etcd-1 \
  --initial-advertise-peer-urls https://192.168.1.11:2380 \
  --listen-peer-urls https://192.168.1.11:2380 \
  --listen-client-urls https://192.168.1.11:2379,https://127.0.0.1:2379 \
  --advertise-client-urls https://192.168.1.11:2379 \
  --initial-cluster-token etcd-cluster \
  --initial-cluster etcd-1=https://192.168.1.11:2380,etcd-2=https://192.168.1.12:2380,etcd-3=https://192.168.1.13:2380 \
  --initial-cluster-state new \
  --data-dir=/var/lib/etcd \
  --cert-file=/etc/kubernetes/pki/etcd/server.crt \
  --key-file=/etc/kubernetes/pki/etcd/server.key \
  --trusted-ca-file=/etc/kubernetes/pki/etcd/ca.crt \
  --client-cert-auth=true \
  --peer-cert-file=/etc/kubernetes/pki/etcd/peer.crt \
  --peer-key-file=/etc/kubernetes/pki/etcd/peer.key \
  --peer-trusted-ca-file=/etc/kubernetes/pki/etcd/ca.crt \
  --peer-client-cert-auth=true
etcd 备份和恢复:
# etcd backup
ETCDCTL_API=3 etcdctl snapshot save snapshot.db \
  --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key

# etcd recovery
etcdutl snapshot restore snapshot.db \
  --bump-revision=1000000000 --mark-compacted \
  --data-dir=/var/lib/etcd-restore \
  --name=etcd-1 \
  --initial-cluster=etcd-1=https://192.168.1.11:2380 \
  --initial-cluster-token=etcd-cluster \
  --initial-advertise-peer-urls=https://192.168.1.11:2380
etcd 性能优化:
- 磁盘 I/O 优化(推荐 SSD)
- 适当的内存分配
- 定期压缩和碎片整理
- 根据集群规模配置适当数量的 etcd 节点(通常为 3 或 5)
2026 年 7 月更新:etcd v3.7.0 已发布
2026 年 7 月 8 日,SIG etcd 发布了 etcd v3.7.0。亮点如下:
- RangeStream: 以分块方式流式传输大型范围结果,而不是在内存中缓冲整个响应(一项长期期待的功能)
- 性能改进: 优化仅键范围请求,租约更快、更可靠
- 移除了遗留 v2store 的最后残余,并完成了一项重大的 protobuf 改造
- 随附更新的核心依赖项 bbolt v1.5.0 和 raft v3.7.0
有关详情,请参阅官方公告和 etcd v3.7 变更日志。
kube-scheduler
kube-scheduler 是选择运行新建 Pod 的节点的控制平面组件。
调度流程:
筛选: 识别可以运行 Pod 的节点
- 资源要求(CPU、内存)
- 节点选择器、节点亲和性
- 污点和容忍
- 卷约束
评分: 为适合的节点分配分数
- 资源利用率
- Pod 间亲和性/反亲和性
- 数据局部性
- 跨节点负载均衡
绑定: 将 Pod 分配给最优节点
Scheduler 配置:
# Basic configuration example
kube-scheduler \
  --kubeconfig=/etc/kubernetes/scheduler.conf \
  --leader-elect=true \
  --v=2
Scheduler 配置文件和插件:
- 默认 scheduler 配置文件
- 自定义 scheduler 配置文件
- scheduler 扩展点(filter、score、bind 等)
- 多 scheduler 支持
调度策略:
# Scheduling policy example
apiVersion: kubescheduler.config.k8s.io/v1
kind: KubeSchedulerConfiguration
profiles:
- schedulerName: default-scheduler
  pluginConfig:
  - name: NodeResourcesFit
    args:
      scoringStrategy:
        type: MostAllocated
        resources:
        - name: cpu
          weight: 1
        - name: memory
          weight: 1
kube-controller-manager
kube-controller-manager 是运行多个 controller 进程的控制平面组件。每个 controller 管理集群的一个特定方面。
主要 Controller:
- Node Controller: 监视并响应节点状态
- Replication Controller: 维护 Pod 副本数量
- EndpointSlice Controller: 跟踪 EndpointSlice 中的 Service 后端
- Service Account & Token Controllers: 创建默认 ServiceAccount,并维护明确请求的旧版 token Secret;当前 Pod 使用短期 TokenRequest token
- Job Controller: 管理一次性任务
- CronJob Controller: 管理计划任务
- DaemonSet Controller: 确保特定 Pod 在所有节点上运行
- StatefulSet Controller: 管理有状态应用程序
- PV Controller: 管理持久卷
- Namespace Controller: 管理 namespace 生命周期
- Garbage Collector: 清理孤立对象
Controller Manager 配置:
# Basic configuration example
kube-controller-manager \
  --kubeconfig=/etc/kubernetes/controller-manager.conf \
  --leader-elect=true \
  --use-service-account-credentials=true \
  --root-ca-file=/etc/kubernetes/pki/ca.crt \
  --service-account-private-key-file=/etc/kubernetes/pki/sa.key \
  --cluster-signing-cert-file=/etc/kubernetes/pki/ca.crt \
  --cluster-signing-key-file=/etc/kubernetes/pki/ca.key \
  --controllers=*,bootstrapsigner,tokencleaner
Controller 操作:
- Controller 持续通过 API server 监视集群状态
- 检测当前状态和期望状态之间的差异
- 执行操作以协调该差异
- 向 API server 报告状态变更
cloud-controller-manager
cloud-controller-manager 是包含云特定控制逻辑的控制平面组件。这使 Kubernetes 核心可与云提供商 API 分离。
主要 Controller:
- Node Controller: 通过云提供商 API 检查节点状态
- Route Controller: 在云环境中配置路由
- Service Controller: 创建、更新和删除云负载均衡器
云存储预配和附加使用 CSI controller;kubelet 和 CSI node plugin 处理挂载。这些不属于 cloud-controller-manager 的职责。
云提供商实现:
- AWS Cloud Controller Manager
- Azure Cloud Controller Manager
- GCP Cloud Controller Manager
- OpenStack Cloud Controller Manager
- vSphere Cloud Controller Manager
Cloud Controller Manager 配置:
# AWS Cloud Controller Manager example
cloud-controller-manager \
  --cloud-provider=aws \
  --cloud-config=/etc/kubernetes/cloud-config \
  --kubeconfig=/etc/kubernetes/cloud-controller-manager.conf \
  --leader-elect=true
Cloud Controller Manager 优势:
- 将云提供商特定代码与 Kubernetes 核心分离
- 云提供商可独立开发自己的功能
- 无需更改 Kubernetes 核心即可添加云功能
节点组件
节点是 Kubernetes 集群中运行容器化应用程序的工作机器。每个节点由控制平面管理,并由多个组件组成。
kubelet
kubelet 是在每个节点运行的代理,用于管理 Pod 内的容器。kubelet 通过多种机制接收 PodSpec,并确保容器按照这些规格健康运行。
主要功能:
- 根据 PodSpec 运行容器
- 监视并报告容器状态
- 管理容器生命周期
- 管理卷挂载
- 报告节点状态
- 执行容器健康检查
kubelet 配置:
# Basic configuration example
kubelet \
  --kubeconfig=/etc/kubernetes/kubelet.conf \
  --config=/var/lib/kubelet/config.yaml \
  --container-runtime-endpoint=unix:///run/containerd/containerd.sock
kubelet 配置文件示例:
# /var/lib/kubelet/config.yaml
apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration
address: 0.0.0.0
authentication:
  anonymous:
    enabled: false
  webhook:
    cacheTTL: 2m0s
    enabled: true
  x509:
    clientCAFile: /etc/kubernetes/pki/ca.crt
authorization:
  mode: Webhook
  webhook:
    cacheAuthorizedTTL: 5m0s
    cacheUnauthorizedTTL: 30s
cgroupDriver: systemd
clusterDomain: cluster.local
cpuManagerPolicy: none
evictionHard:
  memory.available: 100Mi
  nodefs.available: 10%
  nodefs.inodesFree: 5%
failSwapOn: true
healthzBindAddress: 127.0.0.1
healthzPort: 10248
静态 Pod: 以下 manifest 是一个片段,而不是完整的控制平面安装;它还需要主机网络、证书、挂载和完整的 API server 配置。 kubelet 可运行由其直接管理、无需经过 API server 的静态 Pod。这主要用于运行控制平面组件。
# /etc/kubernetes/manifests/kube-apiserver.yaml
apiVersion: v1
kind: Pod
metadata:
  name: kube-apiserver
  namespace: kube-system
spec:
  containers:
  - name: kube-apiserver
    image: registry.k8s.io/kube-apiserver:v1.37.1
    command:
    - kube-apiserver
    - --advertise-address=192.168.1.10
    # ... additional flags
kube-proxy
kube-proxy 是在每个节点运行的网络代理,用于实现 Kubernetes Service 概念。它维护节点上的网络规则并执行连接转发。
主要功能:
- 维护 service IP 和端口的网络规则
- 连接转发
- 实现负载均衡
- 支持服务发现
运行模式:
- iptables: 默认 Linux 模式;安装内核数据包处理规则
- nftables: 自 v1.33 起稳定;请检查内核和 CNI 兼容性
- IPVS: 旧版 Linux 模式,自 v1.35 起弃用;应迁移到受支持的替代方案
- kernelspace: Windows 模式
旧 userspace 模式已被移除。某些网络实现会完全替换 kube-proxy。
kube-proxy 配置:
# Basic configuration example
kube-proxy \
  --config=/var/lib/kube-proxy/config.conf \
  --hostname-override=node1
kube-proxy 配置文件示例:
# /var/lib/kube-proxy/config.conf
apiVersion: kubeproxy.config.k8s.io/v1alpha1
kind: KubeProxyConfiguration
bindAddress: 0.0.0.0
clientConnection:
  acceptContentTypes: ""
  burst: 10
  contentType: application/vnd.kubernetes.protobuf
  kubeconfig: /var/lib/kube-proxy/kubeconfig.conf
  qps: 5
clusterCIDR: 10.244.0.0/16
configSyncPeriod: 15m0s
conntrack:
  maxPerCore: 32768
  min: 131072
  tcpCloseWaitTimeout: 1h0m0s
  tcpEstablishedTimeout: 24h0m0s
enableProfiling: false
healthzBindAddress: 0.0.0.0:10256
hostnameOverride: node1
iptables:
  masqueradeAll: false
  masqueradeBit: 14
  minSyncPeriod: 0s
  syncPeriod: 30s
ipvs:
  excludeCIDRs: null
  minSyncPeriod: 0s
  scheduler: ""
  syncPeriod: 30s
mode: "iptables"
IPVS 与 iptables 模式比较:
| 特性 | iptables 模式 | IPVS 模式 |
|---|---|---|
| 性能 | Service 较多时性能下降 | 大型集群中性能更佳 |
| 负载均衡算法 | 默认随机选择后端 | 支持多种算法(rr、lc、dh、sh、sed、nq) |
| 实现 | 网络数据包筛选链 | 基于哈希表 |
| 内核要求 | 默认内核模块 | 需要 IPVS 内核模块 |
Container Runtime
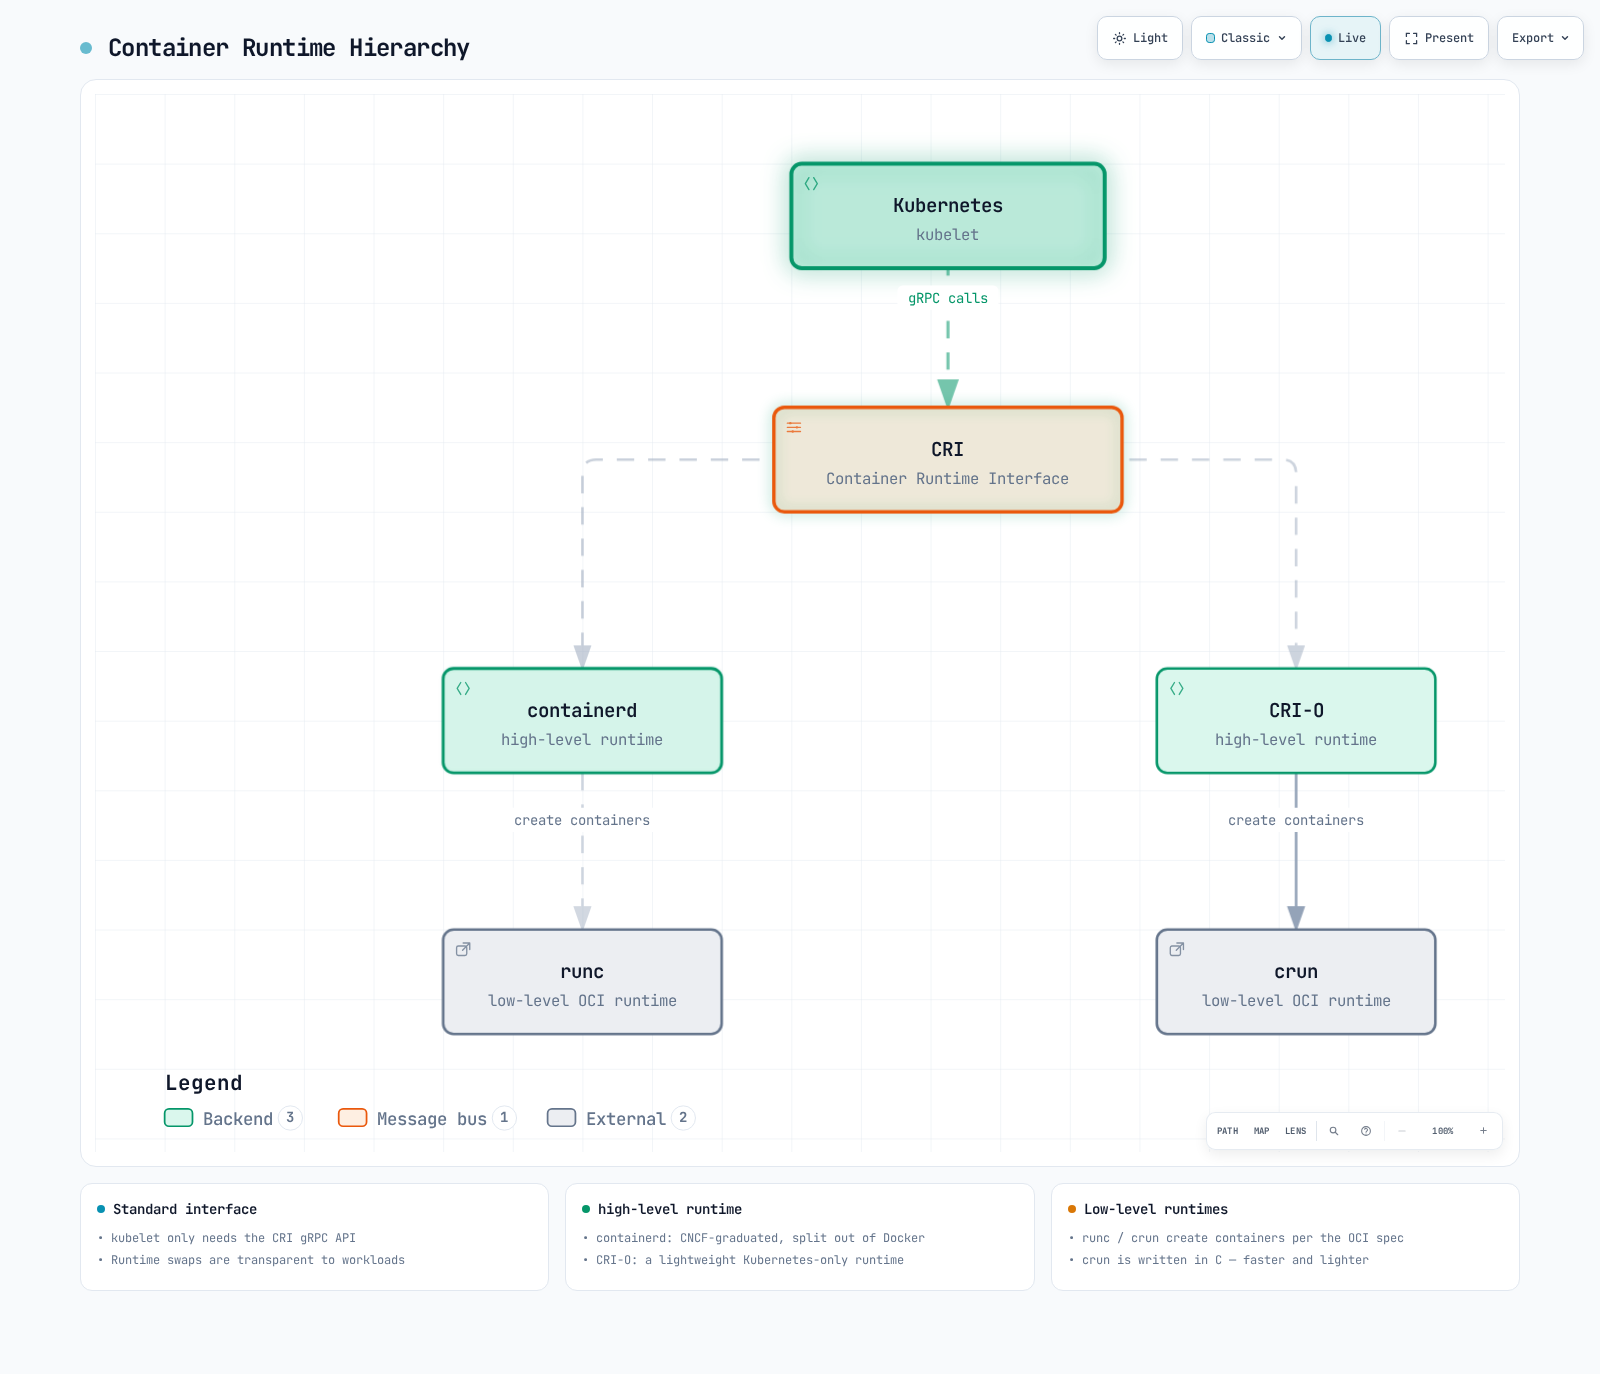
Container Runtime 是运行容器的软件。Kubernetes 通过 Container Runtime Interface(CRI)支持各种容器运行时。
主要 Container Runtime:
- containerd: 轻量级容器运行时(当前使用最广泛)
- CRI-O: 专为 Kubernetes 设计的轻量级运行时
- Docker Engine: 需要如 cri-dockerd 的外部 CRI 适配器;内置 dockershim 已在 v1.24 移除。Docker 构建的 OCI 镜像仍可与 containerd/CRI-O 配合使用。
Container Runtime 分层结构:
containerd 1.x 配置示例(2.x 使用不同的 plugin ID;请为已安装的版本生成默认配置):
# /etc/containerd/config.toml
version = 2

[plugins]
  [plugins."io.containerd.grpc.v1.cri"]
    sandbox_image = "registry.k8s.io/pause:3.10"
    [plugins."io.containerd.grpc.v1.cri".containerd]
      default_runtime_name = "runc"
      [plugins."io.containerd.grpc.v1.cri".containerd.runtimes]
        [plugins."io.containerd.grpc.v1.cri".containerd.runtimes.runc]
          runtime_type = "io.containerd.runc.v2"
          [plugins."io.containerd.grpc.v1.cri".containerd.runtimes.runc.options]
            SystemdCgroup = true
CRI-O 配置示例:
# /etc/crio/crio.conf
[crio]
root = "/var/lib/containers/storage"
runroot = "/var/run/containers/storage"
storage_driver = "overlay"
storage_option = ["overlay.mountopt=nodev"]

[crio.runtime]
default_runtime = "runc"
conmon = "/usr/bin/conmon"
conmon_cgroup = "pod"
cgroup_manager = "systemd"

[crio.image]
pause_image = "registry.k8s.io/pause:3.10"
附加组件
附加组件是扩展 Kubernetes 集群功能的额外组件。一些重要的附加组件包括:
CNI 网络插件: 实现 Pod 网络
- Calico、Cilium、Flannel 等
DNS: 在集群内提供 DNS 服务
- CoreDNS(默认)
Dashboard: 提供基于 Web 的 UI
- Headlamp(Kubernetes Dashboard 已归档)
Ingress Controller: 管理 HTTP/HTTPS 路由
- Traefik、HAProxy 等
Metrics Server: 收集资源使用指标
- Metrics Server
日志和监控: 日志收集和监控
- Prometheus、Grafana、Elasticsearch、Fluentd、Kibana 等
CoreDNS 配置示例:
apiVersion: v1
kind: ConfigMap
metadata:
  name: coredns
  namespace: kube-system
data:
  Corefile: |
    .:53 {
        errors
        health {
            lameduck 5s
        }
        ready
        kubernetes cluster.local in-addr.arpa ip6.arpa {
            pods insecure
            fallthrough in-addr.arpa ip6.arpa
            ttl 30
        }
        prometheus :9153
        forward . /etc/resolv.conf {
            max_concurrent 1000
        }
        cache 30
        loop
        reload
        loadbalance
    }
Calico CNI 配置示例:
apiVersion: v1
kind: ConfigMap
metadata:
  name: calico-config
  namespace: kube-system
data:
  calico_backend: "bird"
  cni_network_config: |-
    {
      "name": "k8s-pod-network",
      "cniVersion": "0.3.1",
      "plugins": [
        {
          "type": "calico",
          "log_level": "info",
          "datastore_type": "kubernetes",
          "nodename": "__KUBERNETES_NODE_NAME__",
          "mtu": __CNI_MTU__,
          "ipam": {
            "type": "calico-ipam"
          },
          "policy": {
            "type": "k8s"
          },
          "kubernetes": {
            "kubeconfig": "__KUBECONFIG_FILEPATH__"
          }
        },
        {
          "type": "portmap",
          "snat": true,
          "capabilities": {"portMappings": true}
        }
      ]
    }
集群通信路径
Kubernetes 集群内的各种组件之间会发生通信。了解这些通信路径对集群设计、安全和故障排查很重要。
控制平面内部通信
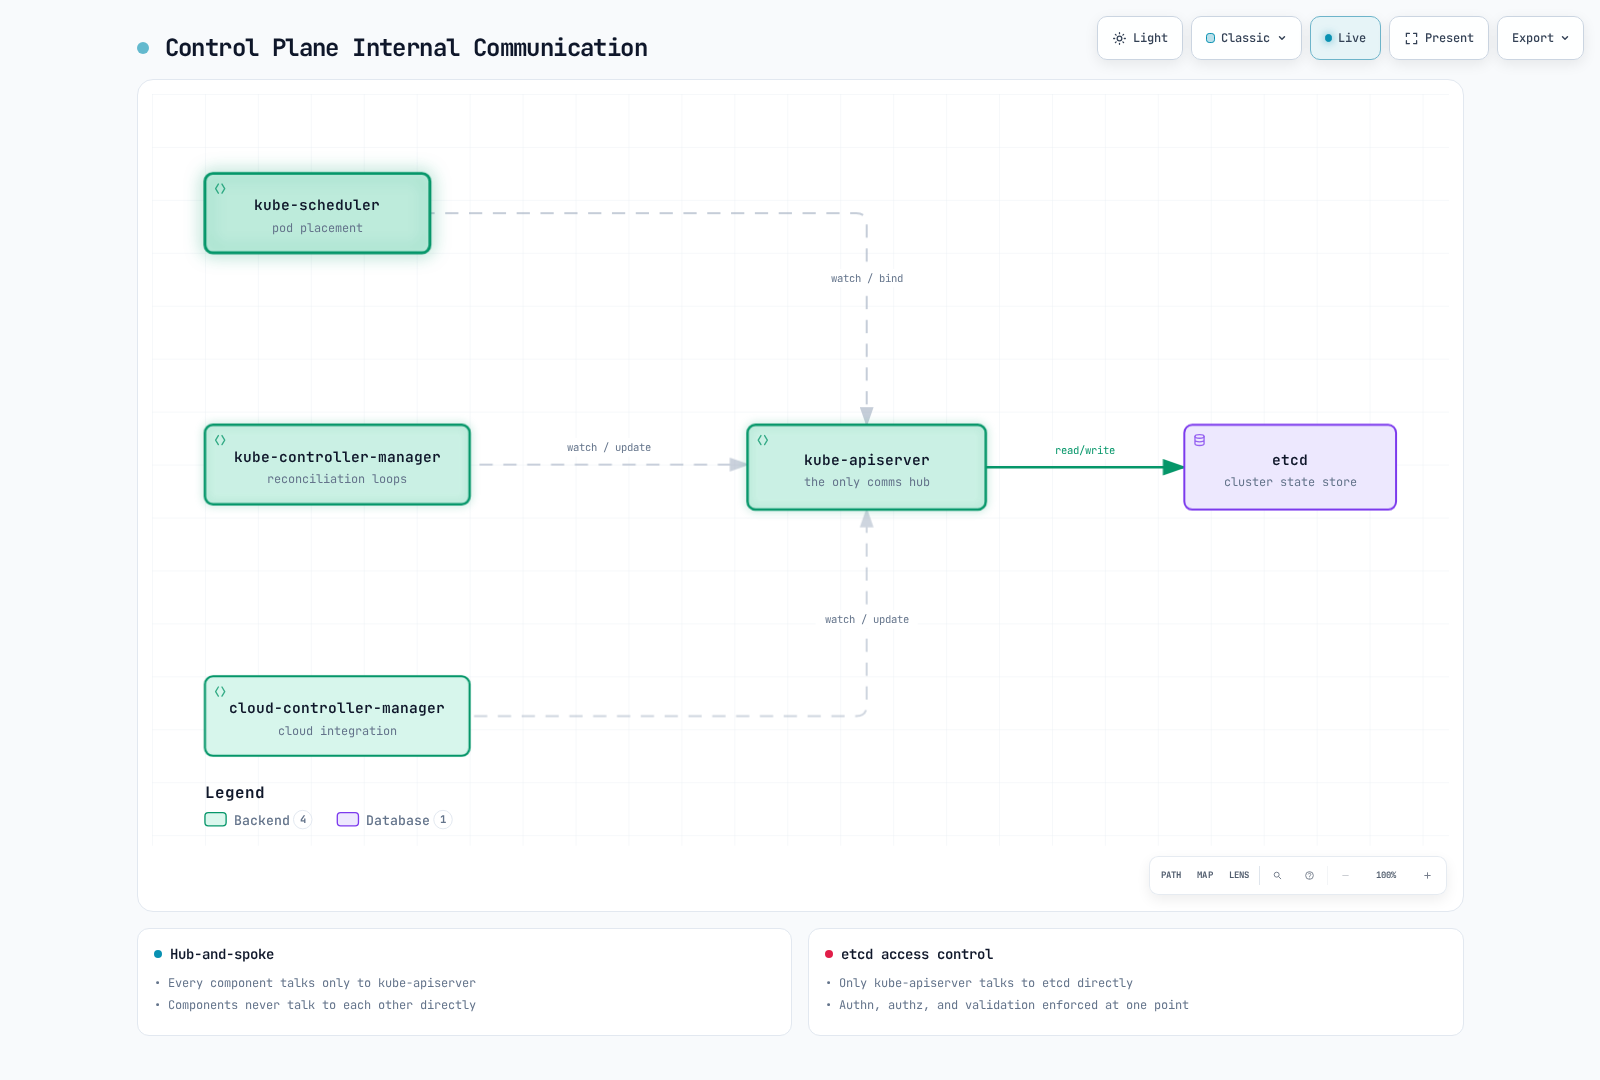
控制平面组件之间的通信如下:
kube-apiserver 和 etcd: kube-apiserver 与 etcd 通信以存储和检索集群状态。
- 协议: gRPC
- 端口: 2379/TCP
- 安全性: 基于 TLS 证书的身份验证
kube-scheduler 和 kube-apiserver: kube-scheduler 为 Pod 调度与 kube-apiserver 通信。
- 协议: HTTPS
- 端口: 6443/TCP (kube-apiserver)
- 安全性: 基于 TLS 证书的身份验证
kube-controller-manager 和 kube-apiserver: Controller 与 kube-apiserver 通信以监视和修改集群状态。
- 协议: HTTPS
- 端口: 6443/TCP (kube-apiserver)
- 安全性: 基于 TLS 证书的身份验证
cloud-controller-manager 和 kube-apiserver: Cloud controller 与 kube-apiserver 通信以监视集群状态并管理云资源。
- 协议: HTTPS
- 端口: 6443/TCP (kube-apiserver)
- 安全性: 基于 TLS 证书的身份验证
控制平面和节点通信
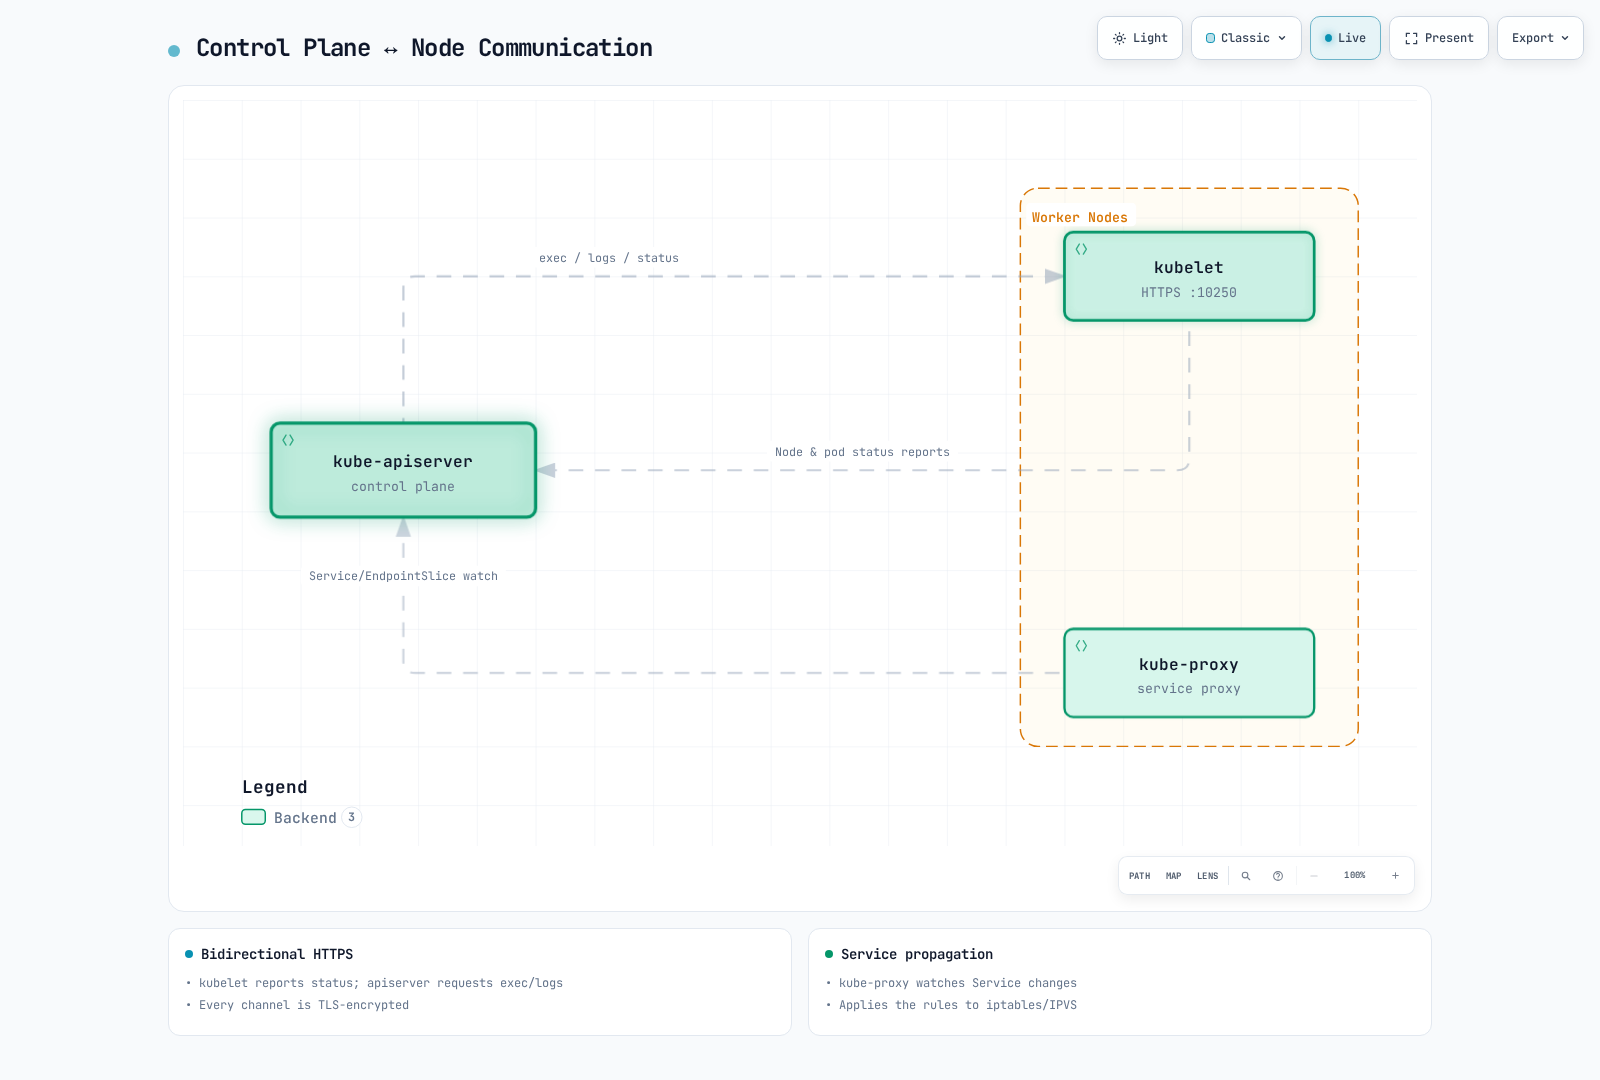
控制平面和节点之间的通信如下:
kube-apiserver → kubelet: API server 调用 kubelet API 用于日志、exec/attach 和端口转发。
- 协议: HTTPS
- 端口: 10250/TCP (kubelet)
- 安全性: 基于 TLS 证书的身份验证
kubelet 和 kube-apiserver: kubelet 与 kube-apiserver 通信,以监视已分配的 PodSpec、注册节点并报告节点/Pod 状态和事件。
- 协议: HTTPS
- 端口: 6443/TCP (kube-apiserver)
- 安全性: 基于 TLS 证书的身份验证
kube-proxy 和 kube-apiserver: kube-proxy 与 kube-apiserver 通信以获取 service 信息。
- 协议: HTTPS
- 端口: 6443/TCP (kube-apiserver)
- 安全性: 基于 TLS 证书的身份验证
节点间通信
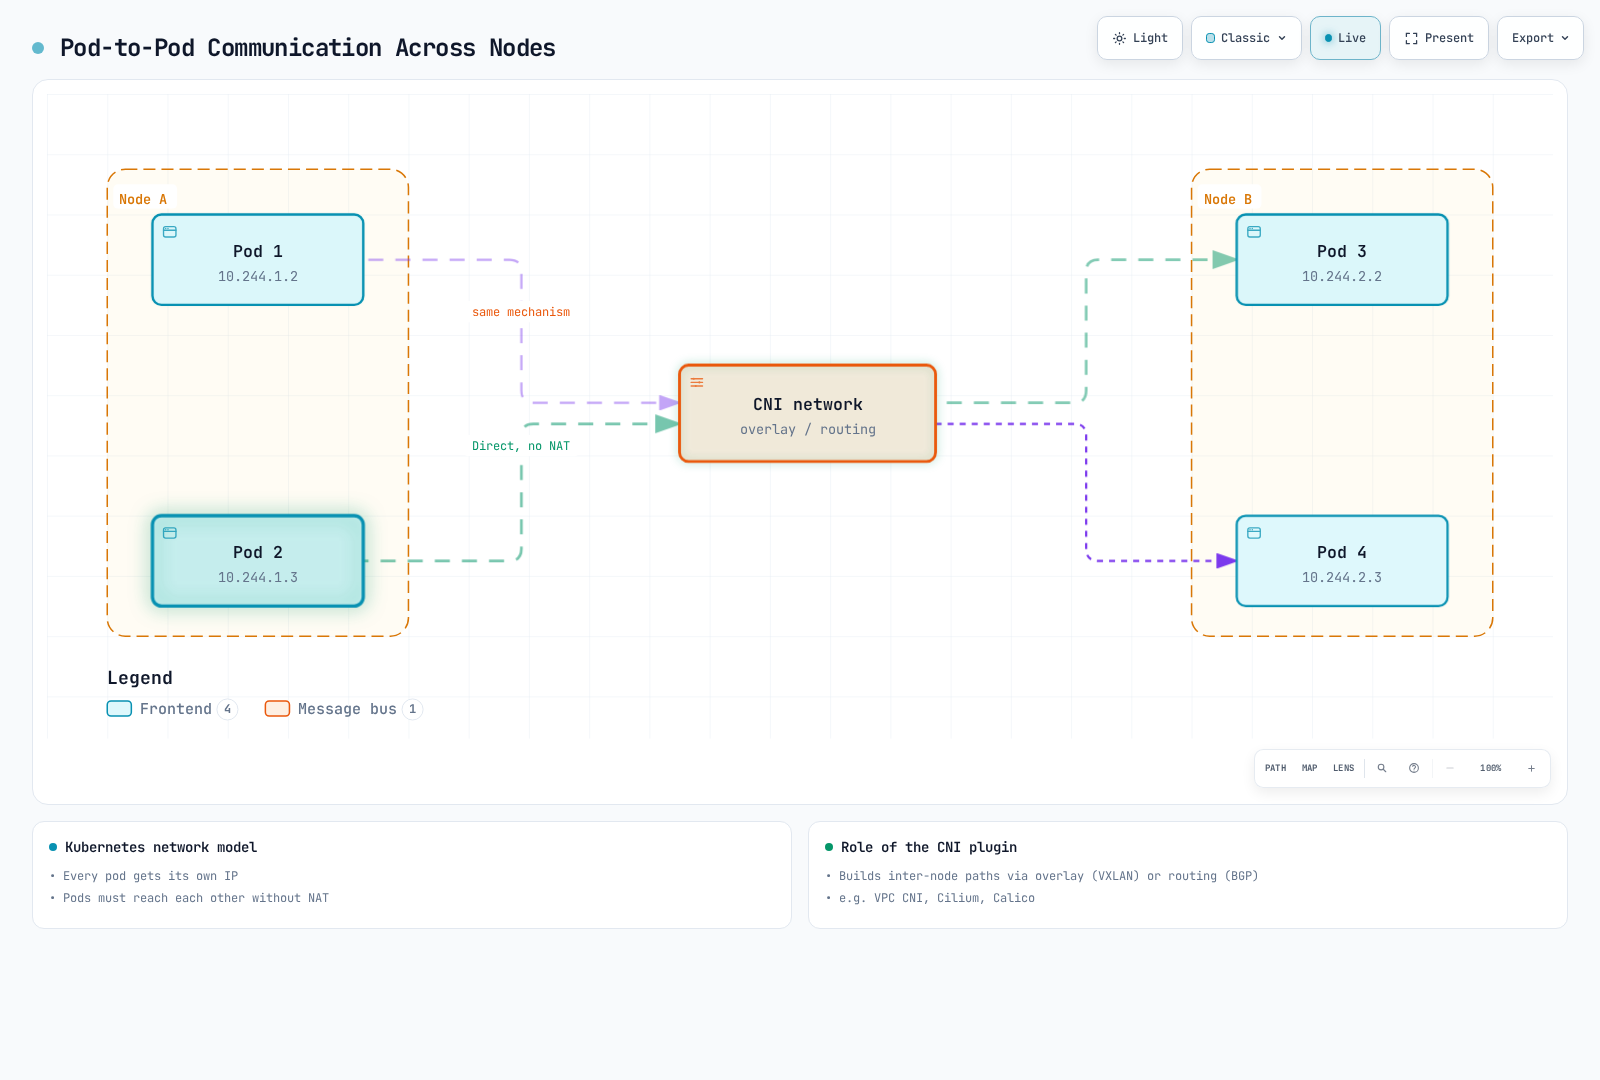
节点间通信如下:
Pod 到 Pod 通信: Pod 通过 CNI plugin 提供的网络彼此通信。
- 协议: 取决于应用程序(TCP、UDP 等)
- 端口: 取决于应用程序
- 安全性: 可通过网络策略控制
跨节点 Pod 通信: 不同节点上的 Pod 之间的通信由 CNI plugin 处理。
- 协议: 取决于应用程序(TCP、UDP 等)
- 端口: 取决于应用程序
- 安全性: 可通过网络策略控制
外部通信
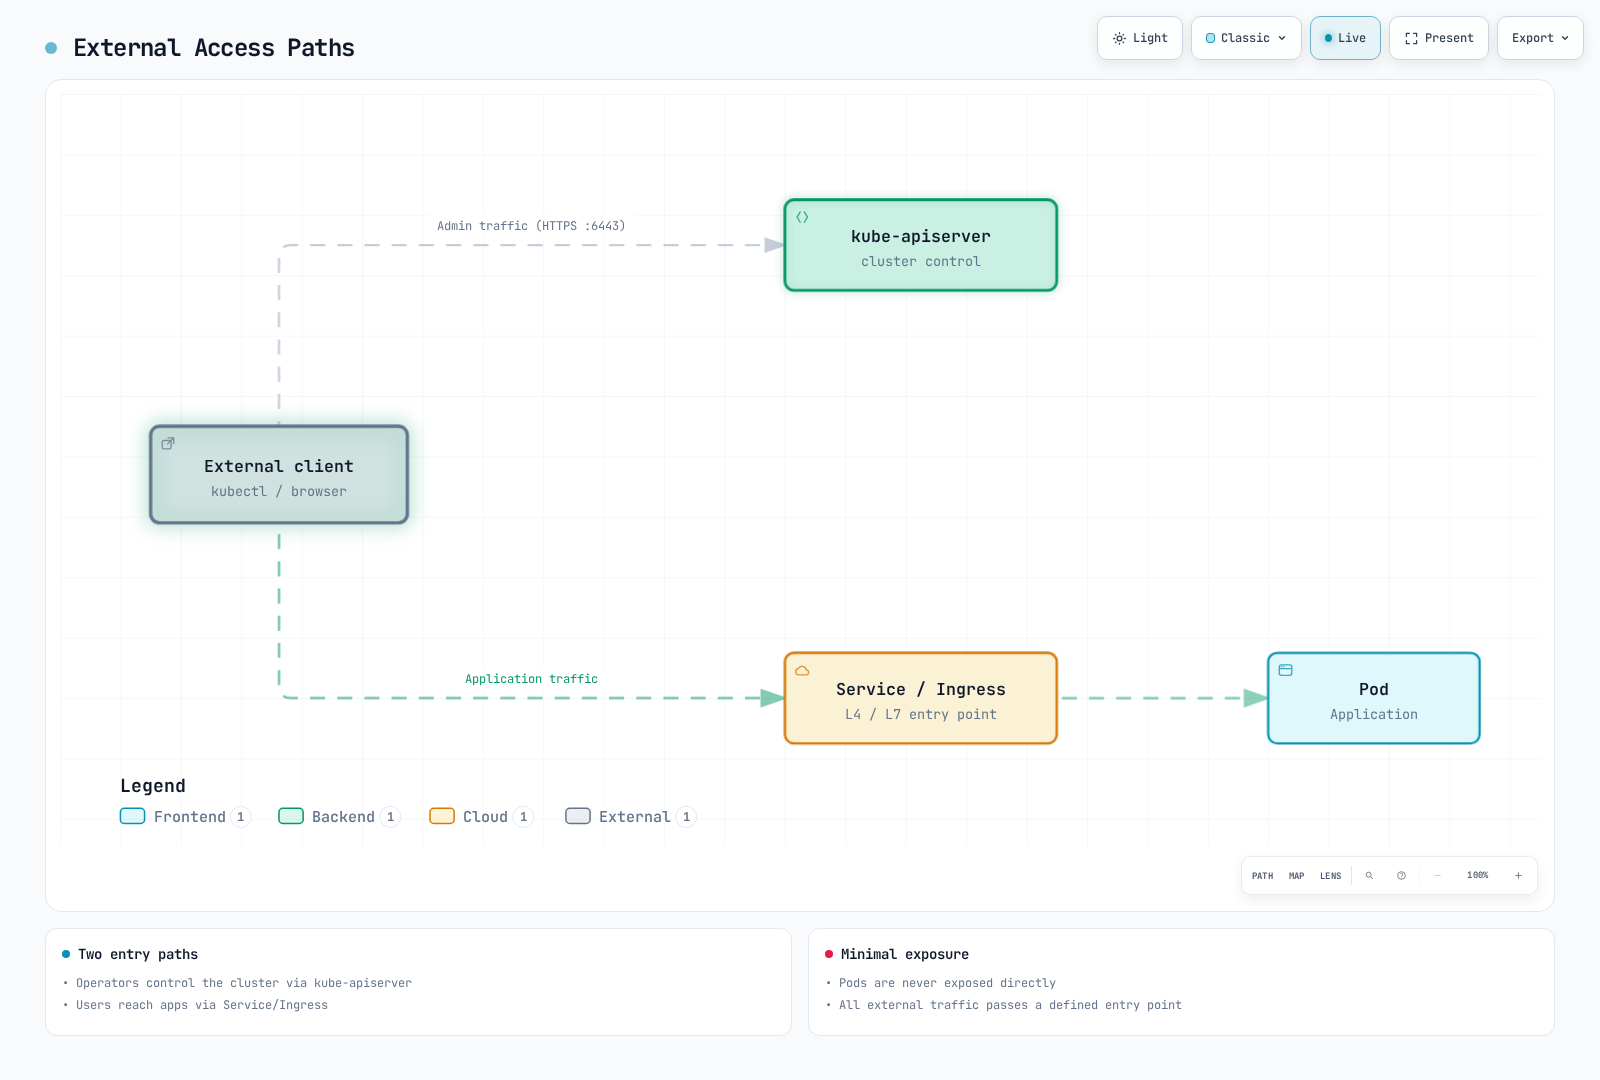
与外部实体的通信如下:
客户端和 kube-apiserver: 用户和外部系统通过 kube-apiserver 与集群交互。
- 协议: HTTPS
- 端口: 6443/TCP (kube-apiserver)
- 安全性: TLS 证书、token、用户身份验证等
外部流量和 Service: 外部流量通过 NodePort、LoadBalancer service 或 Ingress 访问集群内的应用程序。
- 协议: HTTP、HTTPS、TCP、UDP 等
- 端口: 取决于 service 配置
- 安全性: 取决于 ingress controller 和 service 配置
通信安全
Kubernetes 集群内通信的安全性通过以下方式实现:
- TLS 证书: 控制平面组件之间的所有通信均使用 TLS 证书加密。
- 身份验证和授权: 对 API server 的所有请求均经过身份验证和授权流程。
- 网络策略: 可通过网络策略限制 Pod 到 Pod 的通信。
- 加密的 Secret: 存储在 etcd 中的 Secret 可以加密。
API 静态数据加密示例(使用 --encryption-provider-config 配置 API server;重写现有 Secret 以对其加密):
apiVersion: apiserver.config.k8s.io/v1
kind: EncryptionConfiguration
resources:
  - resources:
    - secrets
    providers:
    - aescbc:
        keys:
        - name: key1
          secret: <base64-encoded-key>
    - identity: {}
高可用性集群配置
高可用性(HA)Kubernetes 集群旨在消除单点故障,并在不中断服务的情况下继续运行。
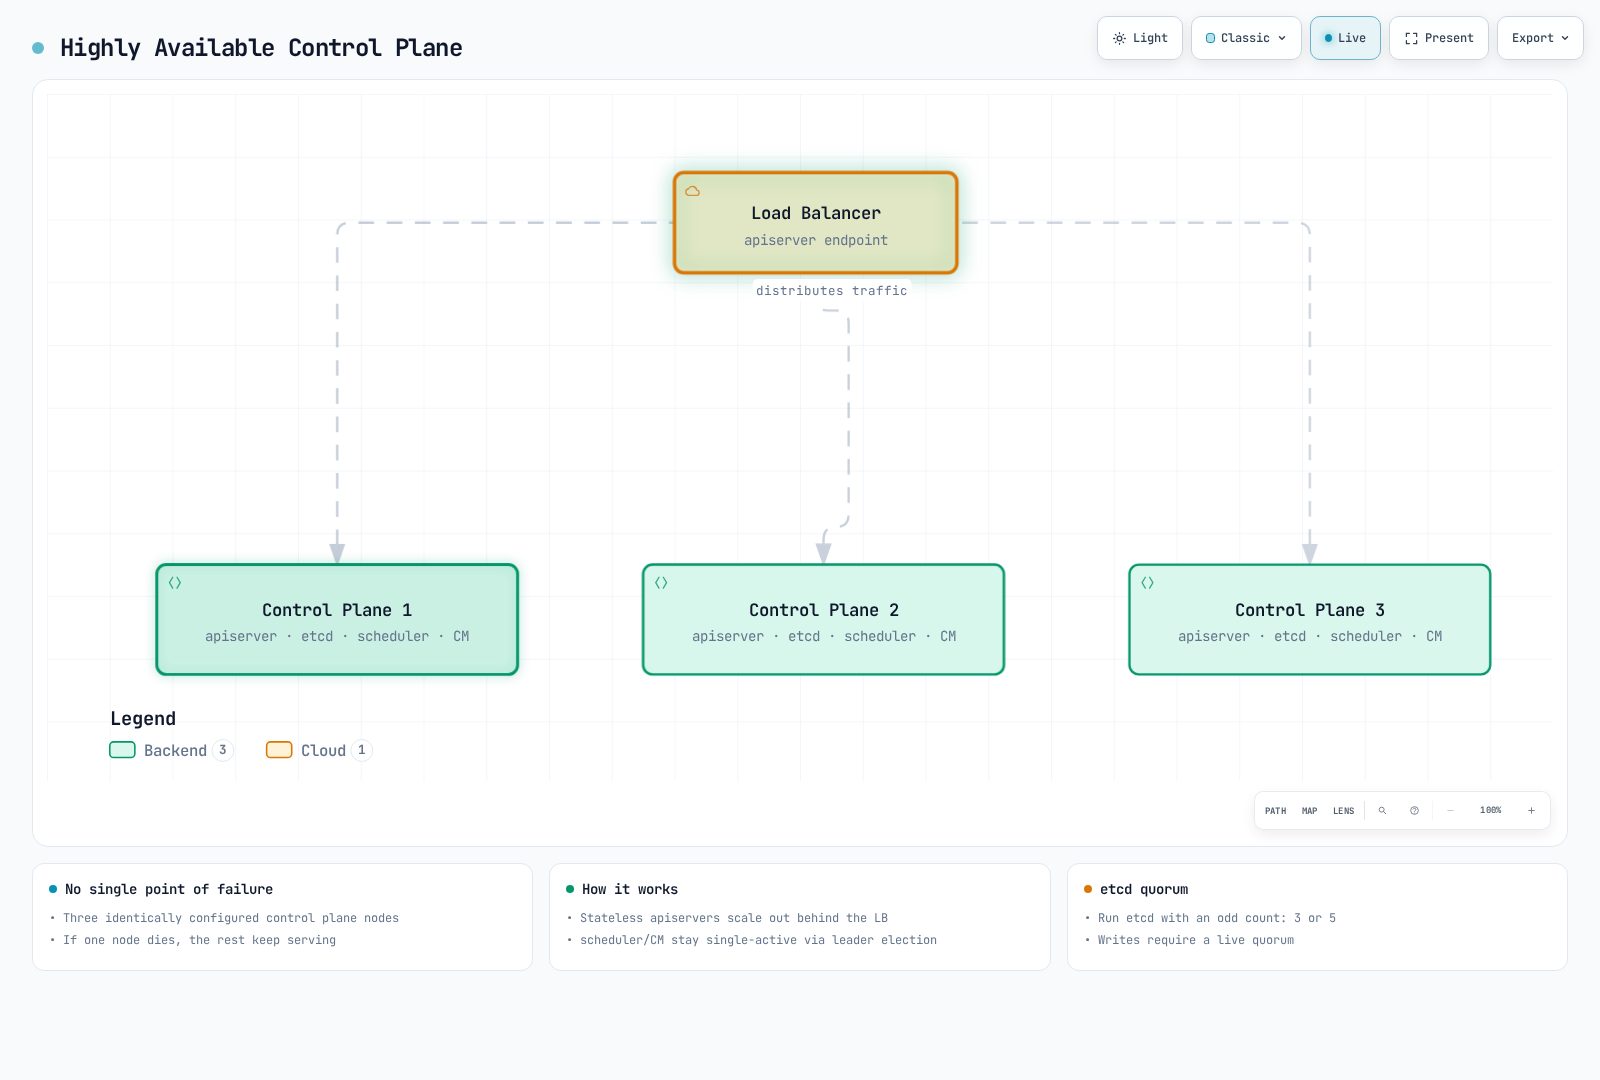
控制平面高可用性
控制平面的高可用性通过以下方式实现:
- 多个控制平面节点: 通常部署 3 或 5 个控制平面节点以实现冗余
- etcd 集群: 部署由多个 etcd 实例组成的集群(通常为 3 或 5 个)
- 负载均衡器: 在 API server 前放置负载均衡器以分配流量
高可用性控制平面架构:
etcd 集群配置:
工作节点高可用性
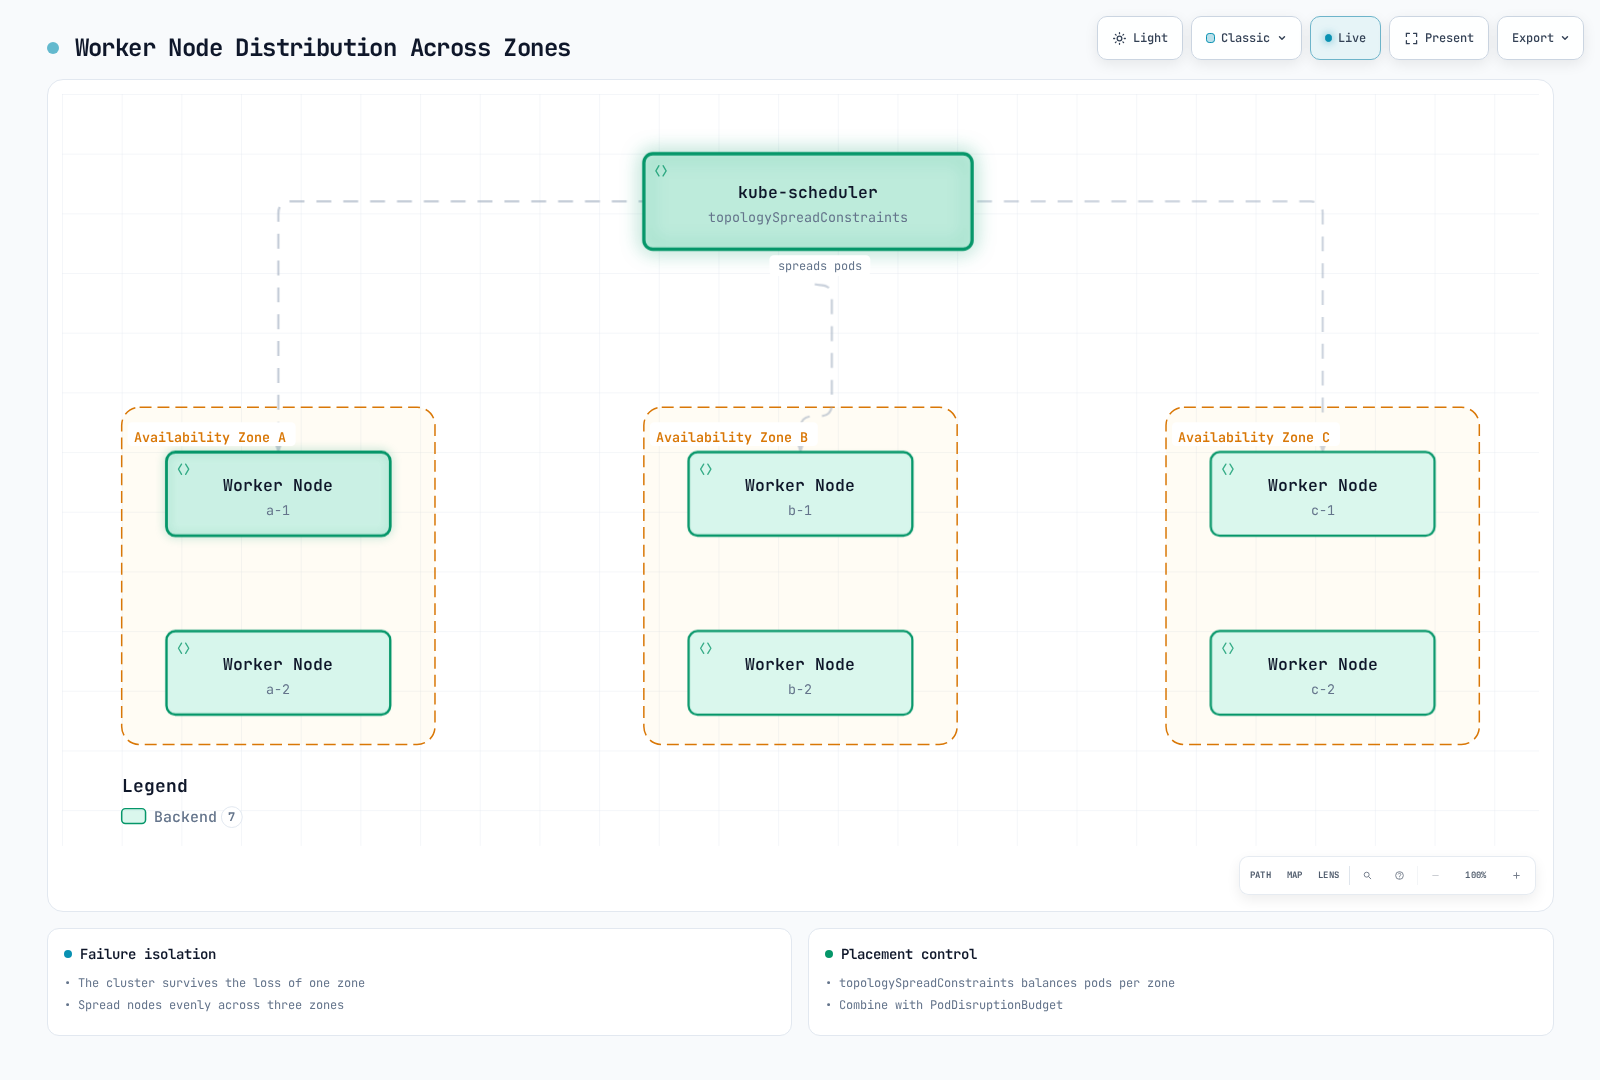
工作节点的高可用性通过以下方式实现:
- 多个工作节点: 将工作负载分布在多个工作节点上
- 自动节点恢复: 利用云提供商的自动恢复功能
- 自动扩缩容: 通过 cluster autoscaler 自动扩展节点
- 多个可用区: 跨多个可用区部署节点
工作节点分布式部署:
应用程序高可用性
应用程序的高可用性通过以下方式实现:
- ReplicaSet/Deployment: 运行多个 Pod 副本
- Pod 分布规则: 通过 Pod 反亲和性将 Pod 分布到多个节点
- PodDisruptionBudget: 确保计划中断期间的最低可用性
- Service 和负载均衡: 将流量分配到多个 Pod
Pod 反亲和性示例:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web-server
spec:
  replicas: 3
  selector:
    matchLabels:
      app: web-server
  template:
    metadata:
      labels:
        app: web-server
    spec:
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - web-server
            topologyKey: "kubernetes.io/hostname"
      containers:
      - name: web-server
        image: nginx:1.30.4
PodDisruptionBudget 示例:
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: web-server-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: web-server
灾难恢复策略
Kubernetes 集群的灾难恢复策略通过以下方式实现:
- etcd 备份和恢复: 建立定期的 etcd 数据备份和恢复程序
- 多区域部署: 跨多个区域部署集群
- 集群联邦: 以联邦方式管理多个集群
- 持续备份: 持续备份应用程序数据
etcd 备份脚本示例:
#!/bin/bash
ETCDCTL_API=3 etcdctl snapshot save /backup/etcd-snapshot-$(date +%Y%m%d-%H%M%S).db \
  --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key
etcd 恢复程序(自主管理的集群):
- 使用
etcdutl snapshot status验证快照。使用兼容的etcdutl将其恢复到新的数据目录,如上所示。 - 在切换数据目录前,依照集群运行手册停止所有 API server 实例和受影响的 etcd 进程。仅停止 kubelet 不会停止现有的静态 Pod 容器。
- 对于多成员恢复,请使用唯一的名称/peer URL 和相同的完整
--initial-cluster成员列表,在每个成员上恢复相同的快照。上面的单成员示例不是 HA 恢复方案。 - 对 Kubernetes watch cache 使用
--bump-revision和--mark-compacted;选择的增量应超过快照后的 revision(所示数值仅为示例)。 - 将 etcd 静态 Pod 的 hostPath 更新为恢复后的目录,重启 etcd,验证 quorum/health,然后重启 API server 和 controller。请保留原始数据和备份,直到验证完成。
遵循 etcd 恢复指南。EKS 用户不会直接操作或恢复托管控制平面的 etcd。
集群网络
Kubernetes 网络使 Pod、service 和外部世界之间能够通信。Kubernetes 网络模型假定每个 Pod 都有唯一的 IP 地址,并且能在无需 NAT 的情况下相互通信。
网络模型
Kubernetes 网络模型有以下要求:
- Pod 到 Pod 通信: 所有 Pod 必须能够无需 NAT 地与所有其他 Pod 通信
- Node 到 Pod 通信: Node agent 必须能够与该节点上的 Pod 通信
- Pod 到外部通信: 外部连接取决于路由、必要时的 NAT 以及安全/egress 策略;并不要求每个 Pod 都能访问互联网
CNI (Container Network Interface)
CNI 是在 Kubernetes 中实现网络的标准接口。有多种 CNI plugin,每种具有不同的功能和性能特征。
主要 CNI Plugin:
Calico: 基于 BGP 的网络,支持网络策略
- 特性: 高性能、网络策略、加密、eBPF 支持
- 使用场景: 大型集群、注重安全的环境
Cilium: 基于 eBPF 的网络和安全
- 特性: L3-L7 安全策略、高性能、可观测性
- 使用场景: 微服务、注重安全的环境
Flannel: 简单的 overlay 网络
- 特性: 设置简单、轻量级
- 使用场景: 小型集群、开发环境
Weave Net(历史): 该项目已于 June 2024 归档;对于新部署,请评估仍在维护的替代方案。
CNI 配置示例 (Calico):
apiVersion: v1
kind: ConfigMap
metadata:
  name: calico-config
  namespace: kube-system
data:
  calico_backend: "bird"
  cni_network_config: |-
    {
      "name": "k8s-pod-network",
      "cniVersion": "0.3.1",
      "plugins": [
        {
          "type": "calico",
          "log_level": "info",
          "datastore_type": "kubernetes",
          "nodename": "__KUBERNETES_NODE_NAME__",
          "mtu": __CNI_MTU__,
          "ipam": {
            "type": "calico-ipam"
          },
          "policy": {
            "type": "k8s"
          },
          "kubernetes": {
            "kubeconfig": "__KUBECONFIG_FILEPATH__"
          }
        },
        {
          "type": "portmap",
          "snat": true,
          "capabilities": {"portMappings": true}
        }
      ]
    }
Service 网络
Kubernetes Service 为一组 Pod 提供稳定的端点。Service 有 ClusterIP、NodePort、LoadBalancer 和 ExternalName 等多种类型。
Service 网络组件:
- ClusterIP: 只能在集群内访问的虚拟 IP
- kube-proxy: 将前往 service IP 的流量路由到 Pod
- CoreDNS: 用于服务发现的 DNS 服务
Service 网络流:
Client -> kernel rules programmed by kube-proxy (ClusterIP DNAT) -> PodService 示例:
apiVersion: v1
kind: Service
metadata:
  name: my-service
spec:
  selector:
    app: my-app
  ports:
  - port: 80
    targetPort: 8080
  type: ClusterIP
Ingress 网络
Ingress 管理从集群外部到集群内部 service 的 HTTP 和 HTTPS 路由。Ingress controller 实现 ingress resource。
主要 Ingress Controller:
- 受维护的 Ingress/Gateway controller: 检查 controller 生命周期和 Gateway API 支持
- AWS Load Balancer Controller: 为 Ingress 预配 ALB
- Traefik: 云原生边缘路由器
- HAProxy Ingress: 基于 HAProxy 的 ingress controller
Ingress 网络流:
Client -> Ingress Controller -> Service -> Pod社区 ingress-nginx 已于 March 2026 退役;请参阅退役公告。此示例需要安装名为 traefik 的 IngressClass 的 Traefik controller;/app 会保持不变地转发。
Ingress 示例:
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: my-ingress
spec:
  ingressClassName: traefik
  rules:
  - host: example.com
    http:
      paths:
      - path: /app
        pathType: Prefix
        backend:
          service:
            name: my-service
            port:
              number: 80
网络策略
网络策略提供了控制 Pod 之间通信的方式。默认情况下,所有 Pod 都能彼此通信,但网络策略可以限制此行为。
网络策略示例:
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: db-network-policy
spec:
  podSelector:
    matchLabels:
      role: db
  policyTypes:
  - Ingress
  - Egress
  ingress:
  - from:
    - podSelector:
        matchLabels:
          role: frontend
    ports:
    - protocol: TCP
      port: 3306
  egress:
  - to:
    - podSelector:
        matchLabels:
          role: monitoring
    ports:
    - protocol: TCP
      port: 9090
网络故障排查
用于排查 Kubernetes 网络问题的常用工具和命令:
- ping、traceroute: 基本网络连通性测试
- tcpdump: 网络数据包捕获和分析
- netstat、ss: 检查网络连接状态
- nslookup、dig: DNS 查找测试
- kubectl exec: 在 Pod 内执行网络命令
网络调试示例:
# Test network connectivity within a pod
kubectl exec -it <pod-name> -- ping <target-ip>

# Test DNS lookup within a pod
kubectl exec -it <pod-name> -- nslookup <service-name>

# Capture network packets within a pod
kubectl exec -it <pod-name> -- tcpdump -i eth0 -n

# Check service endpoints
kubectl get endpointslices -l kubernetes.io/service-name=<service-name>
集群存储
Kubernetes 存储为容器化应用程序提供数据持久性。Kubernetes 提供了各种存储选项和抽象,帮助应用程序高效使用存储。
存储架构
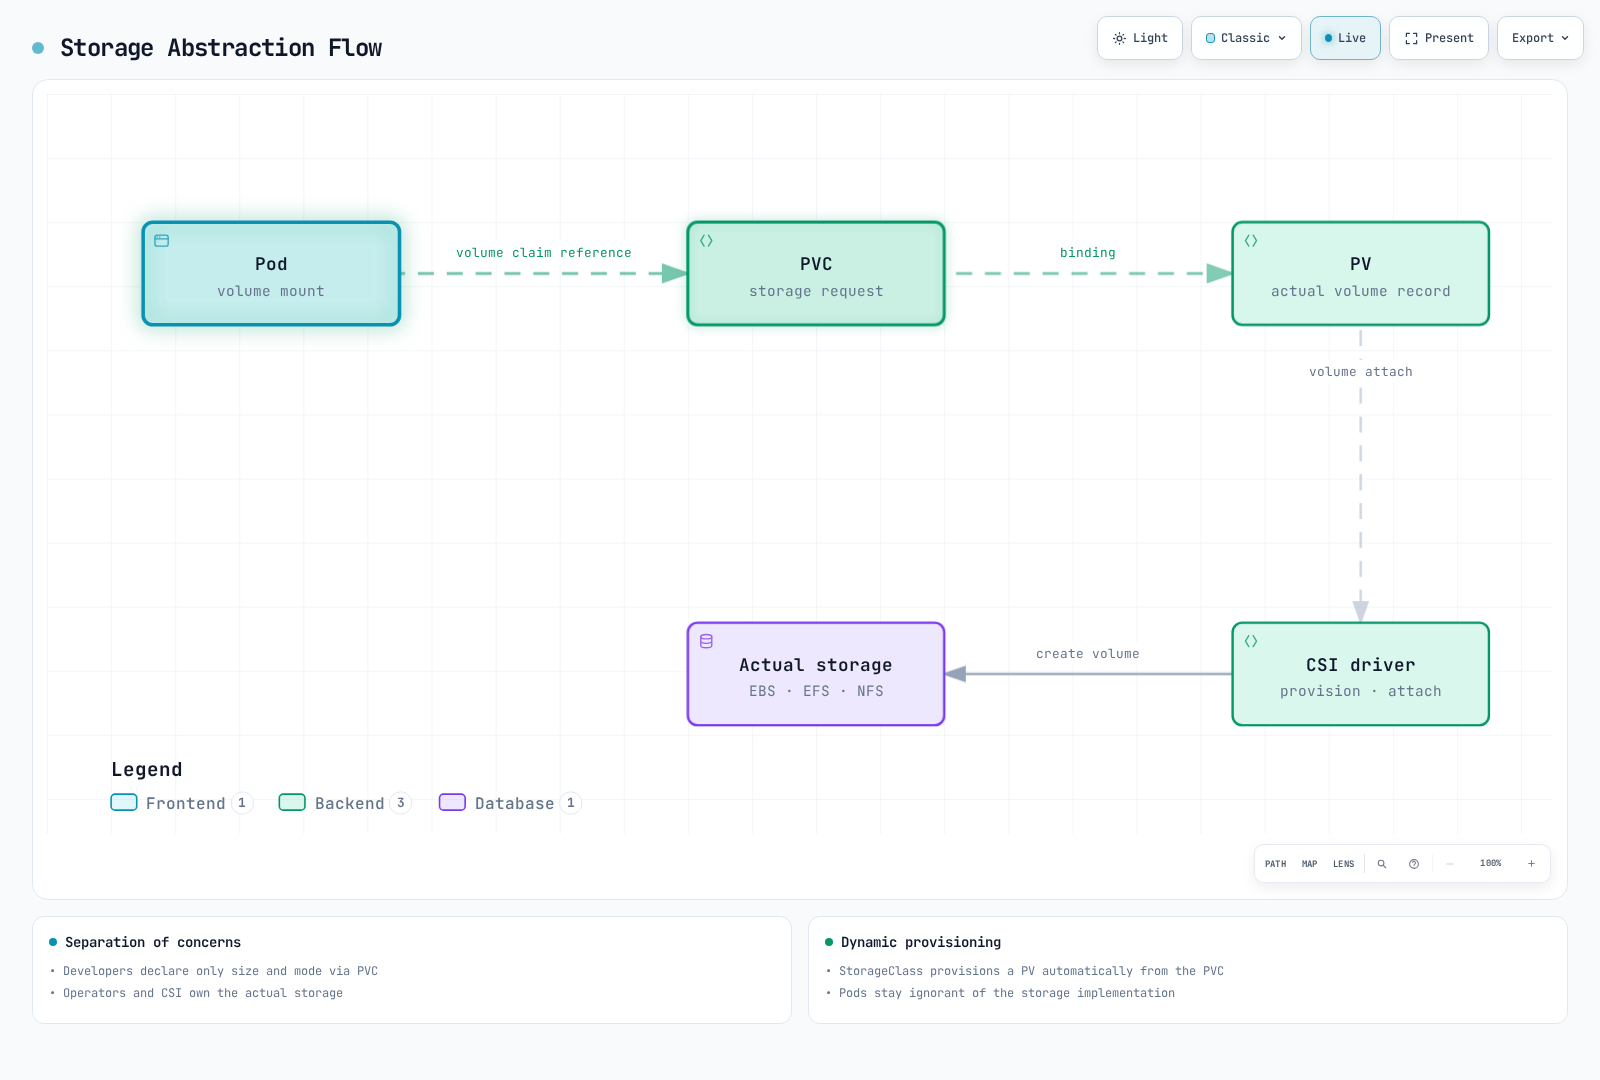
Kubernetes 存储架构由以下组件组成:
- Volumes: 可挂载到 Pod 内容器的目录
- Persistent Volumes (PV): 集群中的存储资源
- Persistent Volume Claims (PVC): 用户的存储请求
- Storage Classes: 定义存储的“类”或类型
- CSI (Container Storage Interface): 与存储系统的标准接口
存储架构流:
Volume 类型
Kubernetes 支持多种类型的 volume:
临时 Volume:
- emptyDir: 以空目录开始,并在 Pod 删除时删除
- configMap: 将 ConfigMap 挂载为 volume
- secret: 将 Secret 挂载为 volume
- downwardAPI: 将 Pod 和容器信息公开为文件
持久 Volume:
- 通过 CSI 的云块存储: AWS EBS、Azure Disk 和 GCE Persistent Disk;它们的旧 in-tree 实现已被移除
- nfs: NFS volume
- csi: 通过 CSI driver 的 volume
Volume 示例:
apiVersion: v1
kind: Pod
metadata:
  name: test-pd
spec:
  containers:
  - name: test-container
    image: nginx
    volumeMounts:
    - mountPath: /test-pd
      name: test-volume
  volumes:
  - name: test-volume
    persistentVolumeClaim:
      claimName: test-pvc
Persistent Volume 和 Claim
Persistent Volume(PV)是由管理员预配或通过 storage class 动态预配的集群存储资源。Persistent Volume Claim(PVC)是用户的存储请求。
请先安装具有 IAM 权限的 EBS CSI driver。对于下面的静态 PV,请将 volume ID 和 zone 替换为现有 EBS volume 及其实际 zone。EBS 无法挂载到 Fargate;EKS Auto Mode 改用 ebs.csi.eks.amazonaws.com。
Persistent Volume 示例:
apiVersion: v1
kind: PersistentVolume
metadata:
  name: pv-example
spec:
  capacity:
    storage: 10Gi
  accessModes:
    - ReadWriteOnce
  persistentVolumeReclaimPolicy: Retain
  storageClassName: standard
  csi:
    driver: ebs.csi.aws.com
    volumeHandle: vol-0123456789abcdef0
    fsType: ext4
  nodeAffinity:
    required:
      nodeSelectorTerms:
      - matchExpressions:
        - key: topology.kubernetes.io/zone
          operator: In
          values: [ap-northeast-2a]
Persistent Volume Claim 示例:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: pvc-example
spec:
  accessModes:
    - ReadWriteOnce
  resources:
    requests:
      storage: 5Gi
  storageClassName: standard
Storage Class
Storage class 描述管理员提供的存储“类”。Storage class 允许在请求 PVC 时动态预配 PV。
Storage Class 示例:
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: standard
provisioner: ebs.csi.aws.com
parameters:
  type: gp3
  csi.storage.k8s.io/fstype: ext4
  encrypted: "true"
reclaimPolicy: Delete
allowVolumeExpansion: true
volumeBindingMode: WaitForFirstConsumer
CSI (Container Storage Interface)
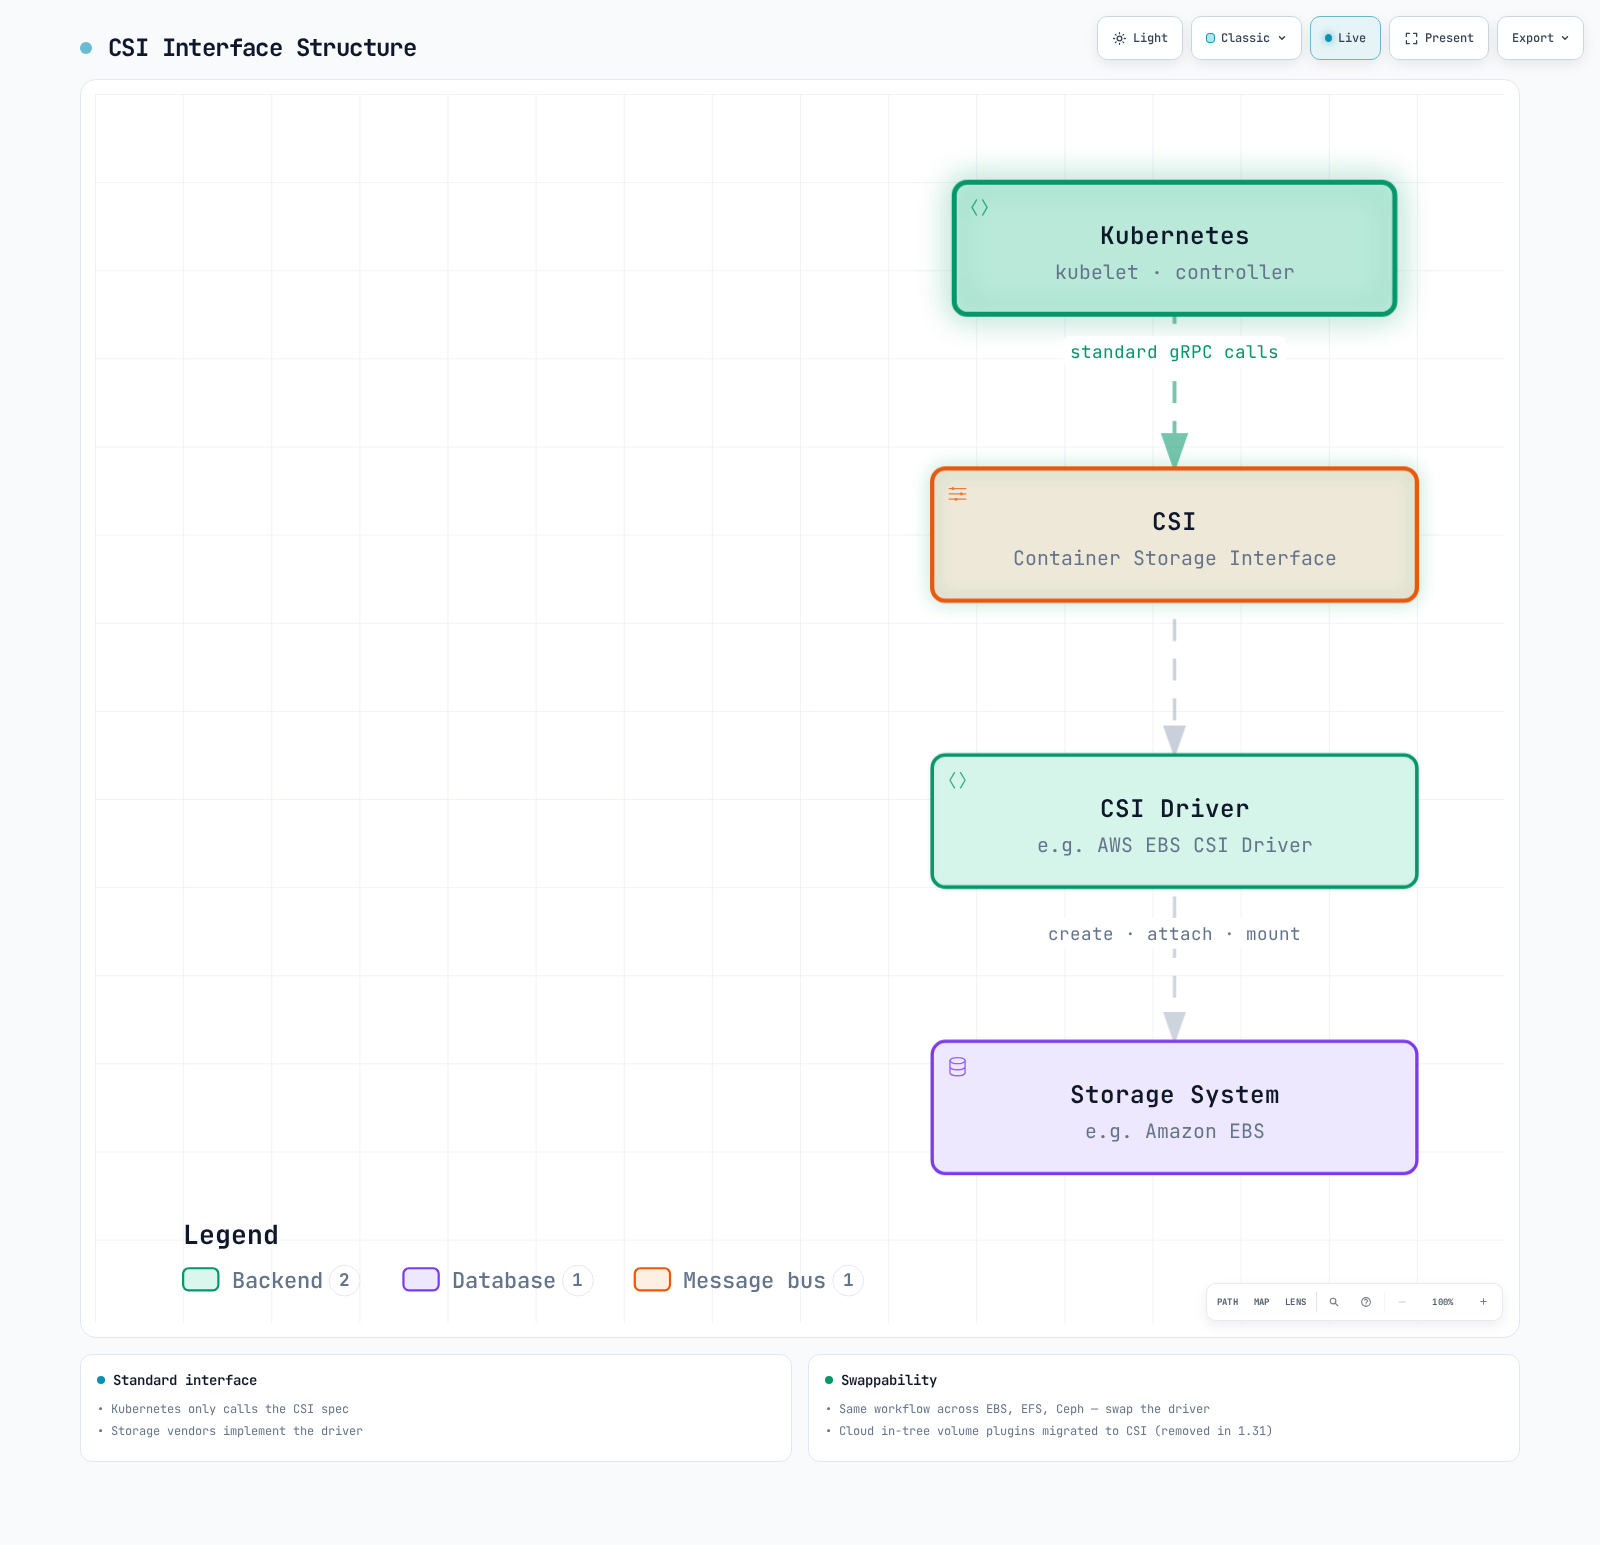
CSI 在 Kubernetes 和存储系统之间提供标准接口。通过 CSI,存储提供商可以在不修改 Kubernetes 代码的情况下开发自己的存储 driver。
CSI 架构:
CSI Driver 部署示例:
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: ebs-sc
provisioner: ebs.csi.aws.com
parameters:
  type: gp3
  csi.storage.k8s.io/fstype: ext4
  encrypted: "true"
volumeBindingMode: WaitForFirstConsumer
存储最佳实践
使用 Kubernetes 存储的最佳实践:
- 选择合适的存储类型: 选择与工作负载特征匹配的存储类型
- 使用动态预配: 通过 storage class 使用动态预配
- 选择合适的访问模式: 选择与工作负载要求匹配的访问模式
- 设置资源请求和限制: 请求适当的存储容量
- 建立备份和恢复策略: 为关键数据准备备份和恢复策略
- 监控存储: 监控存储使用情况和性能
集群可扩展性
Kubernetes 集群可扩展性是指集群处理不断增加的负载和需求的能力。可扩展性可通过水平扩展(scale out)和垂直扩展(scale up)实现。
集群规模限制
上游大型集群指南描述了一个经过测试的支持范围:5,000 个节点、150,000 个总 Pod、300,000 个总容器以及每个节点 110 个 Pod。这些标准共同适用;它们不是通用的硬 API 限制。不存在通用的每个 Pod 20 个容器的限制。Service 容量还取决于地址范围和数据平面。云网络限制和配额可能更低。
水平扩展
水平扩展通过添加更多节点来增加集群容量。
节点自动扩缩容: Kubernetes Cluster Autoscaler 会根据工作负载要求自动调整节点数量。
# AWS Auto Scaling Group tags example
tags:
  k8s.io/cluster-autoscaler/enabled: "true"
  k8s.io/cluster-autoscaler/my-cluster: "owned"
Cluster Autoscaler Deployment 片段(v1.36 集群示例): 请选择与集群次要版本匹配的已修补版本。请提供 ServiceAccount、Kubernetes RBAC 和专用 IAM role;此片段并非完整安装。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: cluster-autoscaler
  namespace: kube-system
spec:
  replicas: 1
  selector:
    matchLabels:
      app: cluster-autoscaler
  template:
    metadata:
      labels:
        app: cluster-autoscaler
    spec:
      containers:
      - name: cluster-autoscaler
        image: registry.k8s.io/autoscaling/cluster-autoscaler:v1.36.0
        command:
        - ./cluster-autoscaler
        - --cloud-provider=aws
        - --nodes=2:10:my-asg-group
- --scale-down-unneeded-time=10mKarpenter: Karpenter 是 AWS 开发的新型节点自动扩缩容工具,提供更快速、更高效的节点预配。
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: default
spec:
  template:
    spec:
      requirements:
        - key: karpenter.sh/capacity-type
          operator: In
          values: ["spot", "on-demand"]
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: default-class
  limits:
    cpu: 1000
    memory: 1000Gi
---
apiVersion: karpenter.k8s.aws/v1
kind: EC2NodeClass
metadata:
  name: default-class
spec:
  role: KarpenterNodeRole-my-cluster
  amiSelectorTerms:
    - alias: al2023@latest
  subnetSelectorTerms:
    - tags:
        karpenter.sh/discovery: my-cluster
  securityGroupSelectorTerms:
    - tags:
        karpenter.sh/discovery: my-cluster
垂直扩展
垂直工作负载扩展会调整 Pod CPU/内存请求。VPA 不会调整底层节点大小;必须另外预配额外节点容量。
Vertical Pod Autoscaler (VPA): VPA 自动调整 Pod 的 CPU 和内存请求。
apiVersion: autoscaling.k8s.io/v1
kind: VerticalPodAutoscaler
metadata:
  name: my-app-vpa
spec:
  targetRef:
    apiVersion: "apps/v1"
    kind: Deployment
    name: my-app
  updatePolicy:
    updateMode: "Recreate"
  resourcePolicy:
    containerPolicies:
    - containerName: '*'
      minAllowed:
        cpu: 100m
        memory: 50Mi
      maxAllowed:
        cpu: 1
        memory: 500Mi
应用程序扩展
应用程序级扩展通过调整 Pod 副本数来实现。
Horizontal Pod Autoscaler (HPA): HPA 根据 CPU 利用率或自定义指标自动调整 Pod 副本数量。
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: my-app-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: my-app
  minReplicas: 2
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 80
KEDA (Kubernetes Event-driven Autoscaling): KEDA 提供事件驱动的自动扩缩容,可基于各种事件源进行扩展。
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: my-app-scaledobject
spec:
  scaleTargetRef:
    name: my-app
  minReplicaCount: 0
  maxReplicaCount: 10
  triggers:
  - type: kafka
    metadata:
      bootstrapServers: kafka.svc:9092
      consumerGroup: my-group
      topic: my-topic
      lagThreshold: "10"
可扩展性最佳实践
Kubernetes 集群可扩展性的最佳实践:
- 设置资源请求和限制: 为所有 Pod 设置适当的资源请求和限制
- 节点池策略: 为不同的工作负载特征配置多个节点池
- 配置自动扩缩容: 正确配置 Cluster Autoscaler、HPA、VPA
- 高效的 Pod 放置: 利用节点亲和性、Pod 亲和性/反亲和性
- 集群监控: 持续监控资源使用情况和性能
- 负载测试: 定期进行负载测试以验证扩展策略
集群安全
Kubernetes 集群安全必须在多个层面实现,包括身份验证、授权、网络策略、Pod 安全等。
身份验证
对 Kubernetes API server 访问进行身份验证的方法:
- X.509 证书: 使用 TLS client certificate 进行身份验证
- Service Account Token: 在 Pod 内访问 API server 的 token
- OpenID Connect (OIDC): 通过外部 identity provider 进行身份验证
- Webhook Token Authentication: 通过外部身份验证服务进行身份验证
- Authentication Proxy: 通过身份验证代理进行身份验证
kubeconfig 示例:
apiVersion: v1
kind: Config
clusters:
- name: my-cluster
  cluster:
    certificate-authority-data: <CA-DATA>
    server: https://api.my-cluster.example.com
users:
- name: admin
  user:
    client-certificate-data: <CERT-DATA>
    client-key-data: <KEY-DATA>
contexts:
- name: my-context
  context:
    cluster: my-cluster
    user: admin
current-context: my-context
授权
控制已验证用户操作的方法:
- RBAC (Role-Based Access Control): 基于角色的访问控制
- ABAC (Attribute-Based Access Control): 基于属性的访问控制
- Node Authorization: 节点专用授权
- Webhook Authorization: 通过外部服务授权
RBAC 示例:
# Role definition
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  namespace: default
  name: pod-reader
rules:
- apiGroups: [""]
  resources: ["pods"]
  verbs: ["get", "watch", "list"]
---
# Role binding
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: read-pods
  namespace: default
subjects:
- kind: User
  name: jane
  apiGroup: rbac.authorization.k8s.io
roleRef:
  kind: Role
  name: pod-reader
  apiGroup: rbac.authorization.k8s.io
网络安全
保护集群内网络流量的方法:
- 网络策略: 控制 Pod 到 Pod 的通信
- 加密通信: 通过 TLS 加密通信
- Service Mesh: 通过 Istio、Linkerd 等实现高级网络安全
网络策略示例:
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-all
spec:
  podSelector: {}
  policyTypes:
  - Ingress
  - Egress
Pod 安全
在 Pod 层面实施安全:
- Pod Security Context: Pod 和容器级别的安全设置
- Pod Security Standards: 定义 Pod 安全要求
- seccomp Profiles: 系统调用限制
- AppArmor/SELinux: 强制访问控制
Pod Security Context 示例:
apiVersion: v1
kind: Pod
metadata:
  name: security-context-pod
spec:
  securityContext:
    runAsUser: 1000
    runAsGroup: 3000
    fsGroup: 2000
  containers:
  - name: app
    image: myapp:1.0
    securityContext:
      allowPrivilegeEscalation: false
      capabilities:
        drop:
        - ALL
Secret 管理
安全管理敏感信息的方法:
- Kubernetes Secrets: 使用基本的 secret resource
- 加密的 etcd: 加密存储在 etcd 中的 secret
- 外部 Secret 管理: 使用 HashiCorp Vault、AWS Secrets Manager 等
加密的 etcd 配置示例:
apiVersion: apiserver.config.k8s.io/v1
kind: EncryptionConfiguration
resources:
  - resources:
    - secrets
    providers:
    - aescbc:
        keys:
        - name: key1
          secret: <base64-encoded-key>
    - identity: {}
安全最佳实践
Kubernetes 集群安全的最佳实践:
- 最小权限原则: 仅授予所需的最低权限
- 定期更新: 定期更新集群和组件
- 网络隔离: 通过网络策略限制 Pod 到 Pod 的通信
- 镜像安全: 只使用可信镜像,并实施漏洞扫描
- 审计日志记录: 为集群活动启用审计日志
- 安全基准: 遵循 CIS benchmark 等安全标准
集群升级
Kubernetes 集群升级是应用新功能、安全补丁和错误修复所必需的。升级必须经过仔细规划和执行。
2026 年 8 月更新:Kubernetes v1.37 “Garhwal” 已发布
Kubernetes v1.37 “Garhwal” 于 August 26, 2026 如期发布。该版本包含 67 项增强功能:16 项升级为 Stable,23 项升级为 Beta,其余作为 Alpha 加入。亮点如下:
- Pod certificate 和 ClusterTrustBundle 升级为 Stable: PodCertificate 功能自动为工作负载颁发和轮换 X.509 certificate,以替代 service account token;用于分发 trust anchor 的 ClusterTrustBundle resource 现在也是标准功能(详细文章)
- Metrics API (metrics.k8s.io) 达到 GA:
kubectl top和 HPA 使用的资源 metrics API 已升级为稳定版本(详细文章) - 其他 Stable 功能:多个 DRA(Dynamic Resource Allocation)功能、有韧性的 watchcache 初始化等;Beta 功能:HPA scale-to-zero、基于 manifest 的 admission control 配置等;Alpha 功能:Pod 级 checkpoint 和 restore 等
- 弃用: kube-dns 和
kubectl run --filename/-f已弃用;ipvs已在 v1.35 弃用,静态 Pod 不再能引用 Secret 或 ConfigMap。对 cgroup v1 支持的移除也在继续推进。
升级前,请务必查看官方发行说明中的弃用和移除项。
升级策略
Kubernetes 集群升级策略:
- 蓝绿升级: 单独创建新版本集群并迁移工作负载
- 原地升级: 直接升级现有集群
- 金丝雀升级: 先仅升级部分节点以进行验证
升级顺序
Kubernetes 集群升级的典型顺序:
- 控制平面升级: kube-apiserver、kube-controller-manager、kube-scheduler、etcd
- DNS 和 CNI 升级: CoreDNS、CNI plugin 和其他主要附加组件
- 工作节点升级: 顺序升级工作节点
kubeadm 升级顺序:
遵循特定版本的 kubeadm 升级指南,并配置目标次要版本的 pkgs.k8s.io package repository。一次只能升级一个次要版本。
- 备份 etcd 并验证附加组件兼容性。在第一个控制平面节点上升级
kubeadm,运行kubeadm upgrade plan,然后运行kubeadm upgrade apply <target-version>。 - 在其他控制平面节点上,升级
kubeadm并运行kubeadm upgrade node。 - 升级每个节点的 kubelet 前先 drain;将 kubelet/kubectl package 升级到选定的 patch,重新加载 systemd,重启 kubelet,验证就绪状态,然后 uncordon。
- 在 worker 上升级
kubeadm,运行kubeadm upgrade node,然后执行 drain/kubelet/uncordon 序列。kubelet 不得比 API server 更新。
升级注意事项
升级 Kubernetes 集群时的注意事项:
- API 变更: 检查新版本中的 API 变更
- Feature Gate: 检查新的 feature gate 和默认值变更
- 依赖项: 检查 CNI、CSI 等依赖组件的兼容性
- 停机时间: 为升级期间预期的停机时间制订计划
- 回滚计划: 建立问题发生时的回滚计划
升级最佳实践
Kubernetes 集群升级的最佳实践:
- 先在测试环境测试: 在生产升级前于测试环境验证
- 渐进式升级: 一次升级一个次要版本
- 备份: 升级前备份 etcd 数据
- 文档: 记录升级程序和结果
- 监控: 在升级期间和之后监控集群状态
- 升级窗口: 在流量低峰期进行升级
Amazon EKS 集群架构
Amazon EKS(Elastic Kubernetes Service)是 AWS 提供的托管 Kubernetes 服务。EKS 提供所有基本 Kubernetes 功能,同时增加与 AWS 服务的集成和管理便利性。
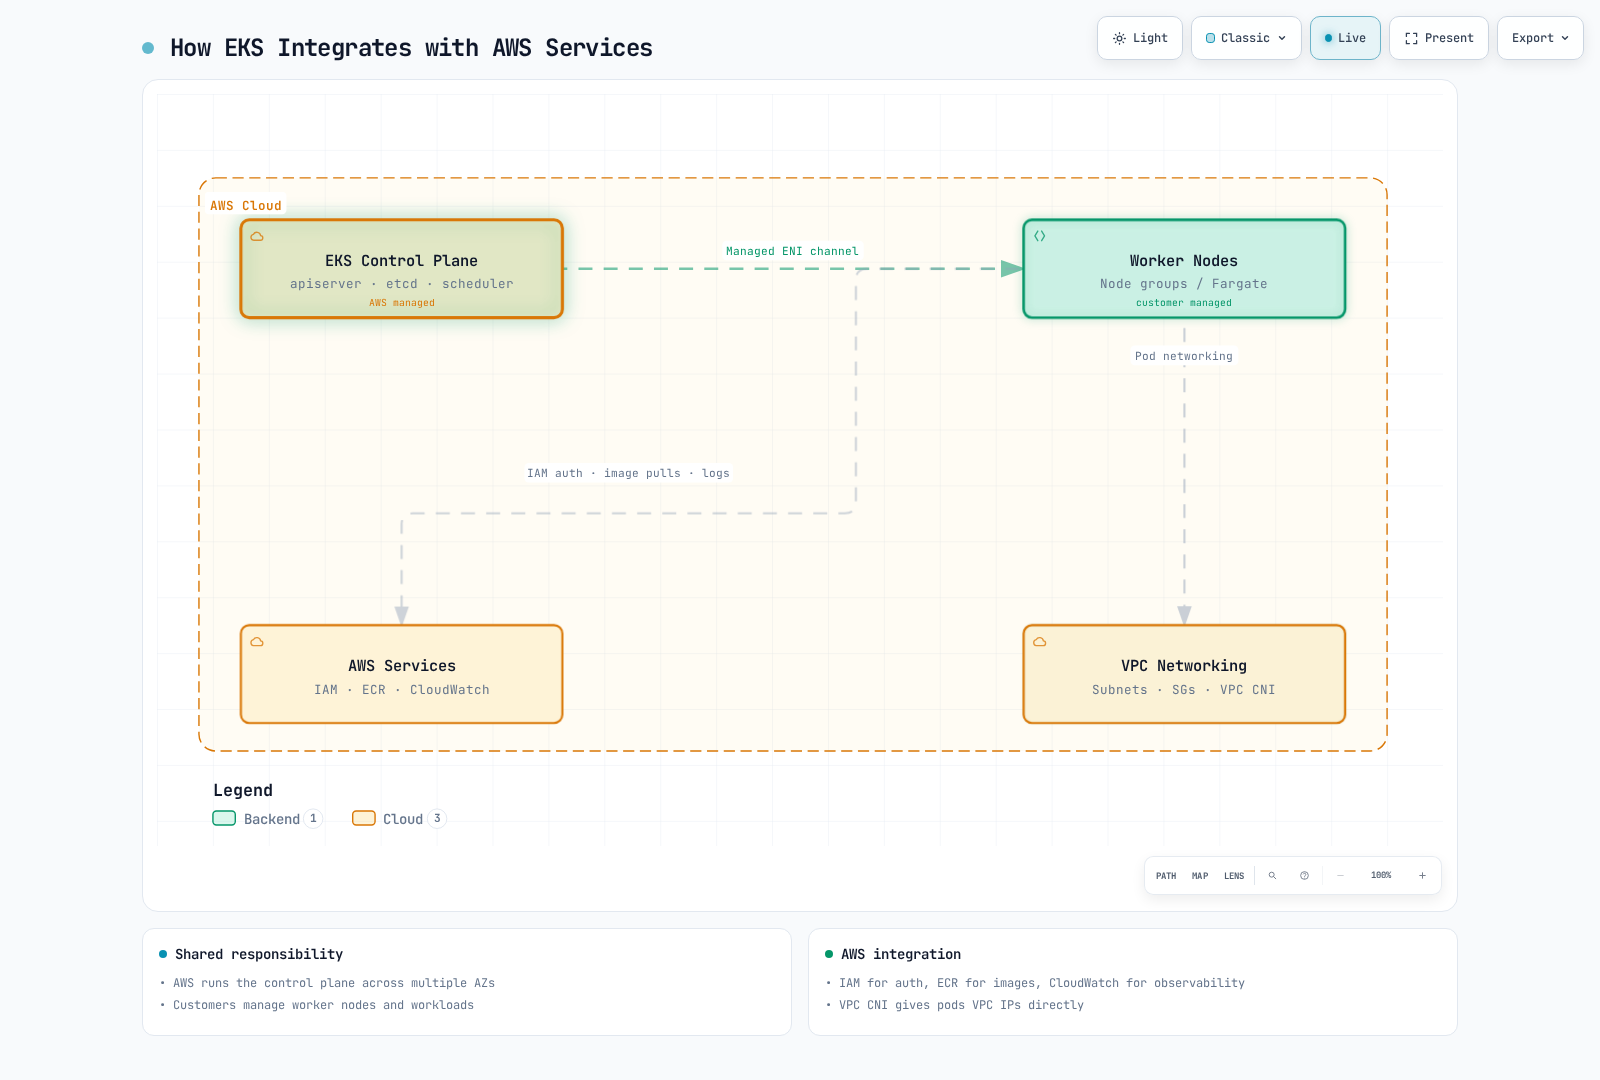
EKS 架构概览
EKS 集群由以下组件组成:
- EKS 控制平面: 由 AWS 管理的 Kubernetes 控制平面
- EKS 节点: 由用户管理的工作节点(EC2 instance)
- EKS 托管节点组: 由 AWS 管理的节点组
- EKS Fargate Profile: 无服务器容器执行环境
- VPC 和 Subnet: 用于集群网络的 VPC 和 subnet
EKS 架构图:
EKS 控制平面
EKS 控制平面由 AWS 管理,并在多个可用区提供高可用性。
主要特性:
- 托管服务: AWS 管理控制平面维护和升级
- 高可用性: 跨多个可用区部署
- 自动扩缩容: 根据负载自动扩展
- 安全性: 与 AWS 安全服务集成
EKS 节点类型
EKS 支持多种节点类型:
- 自主管理节点: 用户直接管理 EC2 instance
- 托管节点组: AWS 管理节点生命周期
- Fargate: 无服务器容器执行环境
- EKS Auto Mode: AWS 管理计算和集成基础设施
- EKS Hybrid Nodes: 客户管理的本地节点
Bottlerocket 是节点操作系统,而不是一种独立的计算管理类型。
托管节点组示例:
apiVersion: eksctl.io/v1alpha5
kind: ClusterConfig
metadata:
  name: my-cluster
  region: ap-northeast-2
managedNodeGroups:
  - name: ng-1
    instanceType: m5.large
    desiredCapacity: 3
    minSize: 2
    maxSize: 5
    volumeSize: 80
    privateNetworking: true
    labels:
      role: worker
    tags:
      nodegroup-role: worker
EKS 网络
EKS 网络基于 Amazon VPC,包含以下组件:
- VPC CNI Plugin: 与 AWS VPC 网络集成
- Security Group: 节点和 Pod 级别的网络安全
- Load Balancer 集成: 与 ELB、ALB、NLB 集成
- VPC Endpoint: 与 AWS 服务的私有通信
VPC CNI add-on 配置示例(JSON 配置值,而不是 ConfigMap):
{
  "enableNetworkPolicy": "true",
  "env": {
    "WARM_IP_TARGET": "5",
    "MINIMUM_IP_TARGET": "10"
  }
}
在更新前,请将这些值与已安装 add-on 的配置合并并验证其 schema。Pod ENI 支持使用 ENABLE_POD_ENI environment variable,且还需要兼容的节点、IAM 权限和 SecurityGroupPolicy;仅使用 ConfigMap key 不会启用它。请参阅网络策略设置。
EKS 存储
EKS 与各种 AWS 存储服务集成:
- EBS CSI Driver: Amazon EBS volume 管理
- EFS CSI Driver: Amazon EFS file system 管理
- FSx for Lustre CSI Driver: FSx for Lustre file system 管理
- S3: 对象存储
EBS CSI Driver 示例:
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: ebs-sc
provisioner: ebs.csi.aws.com
parameters:
  type: gp3
  encrypted: "true"
volumeBindingMode: WaitForFirstConsumer
EKS 安全
EKS 与 AWS 安全服务集成以提供强大的安全性:
- IAM 集成: AWS IAM 和 Kubernetes RBAC 的集成
- VPC 安全: VPC security group 和 network ACL
- AWS KMS: 用于 secret 加密的 KMS 集成
- AWS WAF: Web application firewall 集成
- AWS Shield: DDoS 防护
IAM Role Service Account 示例:
apiVersion: v1
kind: ServiceAccount
metadata:
  name: s3-reader
  namespace: default
  annotations:
    eks.amazonaws.com/role-arn: arn:aws:iam::123456789012:role/s3-reader-role
EKS 监控和日志记录
EKS 与 AWS 监控和日志服务集成:
- CloudWatch Container Insights: 容器监控
- CloudWatch Logs: 日志收集和分析
- X-Ray: 分布式追踪
- Prometheus 和 Grafana: 开源监控工具集成
CloudWatch Container Insights 示例:
apiVersion: v1
kind: Namespace
metadata:
  name: amazon-cloudwatch
---
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: cloudwatch-agent
  namespace: amazon-cloudwatch
spec:
  selector:
    matchLabels:
      name: cloudwatch-agent
  template:
    metadata:
      labels:
        name: cloudwatch-agent
    spec:
      containers:
      - name: cloudwatch-agent
        image: amazon/cloudwatch-agent:1.247347.6b250880
        # ... additional configuration
EKS 成本优化
优化 EKS 集群成本的方法:
- Spot Instances: 使用成本效益高的 Spot instance
- Fargate: 使用无服务器容器执行减少空闲资源成本
- 自动扩缩容: 通过 cluster autoscaler 优化资源
- Graviton Processors: 使用基于 ARM 的 Graviton instance
- 资源请求优化: 设置适当的资源请求和限制
Spot Instance 节点组示例:
apiVersion: eksctl.io/v1alpha5
kind: ClusterConfig
metadata:
  name: my-cluster
  region: ap-northeast-2
managedNodeGroups:
  - name: spot-ng
    instanceTypes: ["m5.large", "m5a.large", "m5d.large", "m5ad.large"]
    spot: true
    desiredCapacity: 3
    minSize: 2
    maxSize: 10
深入学习
要加深对本文档所述集群架构的理解,请参阅以下主题:
- Kubernetes 简介 - Kubernetes 的基本概念和历史
- Pod 和工作负载 - 管理集群中运行的工作负载
- Service 和网络 - 集群内的网络配置
- 调度、抢占和驱逐 - Pod 如何被放置到节点上
- 集群管理 - 集群操作和管理
- EKS 简介 - Amazon EKS 服务概述
- EKS 集群创建 - 如何创建 EKS 集群
实践和进阶学习
- Kubernetes 官方教程 - 通过动手实践学习
- Kubernetes The Hard Way - 手动构建 Kubernetes 集群
- Cilium 网络 - 高级网络和安全功能
结论
本文档介绍了 Kubernetes 集群的架构、主要组件及其协同工作方式。我们还涵盖了集群网络、存储、可扩展性、安全性和升级等重要方面,以及 Amazon EKS 集群的架构。
理解 Kubernetes 集群架构是有效进行集群设计、部署和运维的基础。凭借这些知识,您可以构建稳定、可扩展且安全性增强的 Kubernetes 环境。
测验
要测试您在本章中学到的内容,请尝试集群架构测验。