EKS 上的 Flink 深入指南
Apache Flink 是用于有界和无界流的分布式有状态引擎。JobManager 负责协调执行和恢复;TaskManager 执行算子任务并交换数据。检查点一致性与外部接收端的 exactly-once 行为各有不同要求。第 3 部分将一起讨论数据源、状态和接收端。
最后更新:2026 年 9 月 12 日 集成基线:Flink 2.2.1 / Java 17 / Operator 1.15.0。
第 3 部分的 Iceberg 示例单独使用 Flink 2.1.3 / Iceberg 1.11.0,以匹配其运行时。 请逐章核实 S3 插件的 SDK 支持范围以及托管服务之间的差异。
最新稳定版 Flink 为 2.3.0。本指南以 2.2.1 为基线,并对照已发布的 Operator 和连接器兼容性表进行检查。 CRD 枚举接受某个版本字符串,并不能证明集成兼容性。选择 Kubernetes/kubectl 版本时,应依据当前 EKS 支持范围和版本偏差策略;“Kubernetes 1.21+”并不保证该版本目前受 EKS 支持。
Kubernetes 上各组件的管理职责
- FlinkDeployment 定义 Application 或 Session 集群。
- FlinkSessionJob 定义一个提交到现有受管 Session 集群的作业。
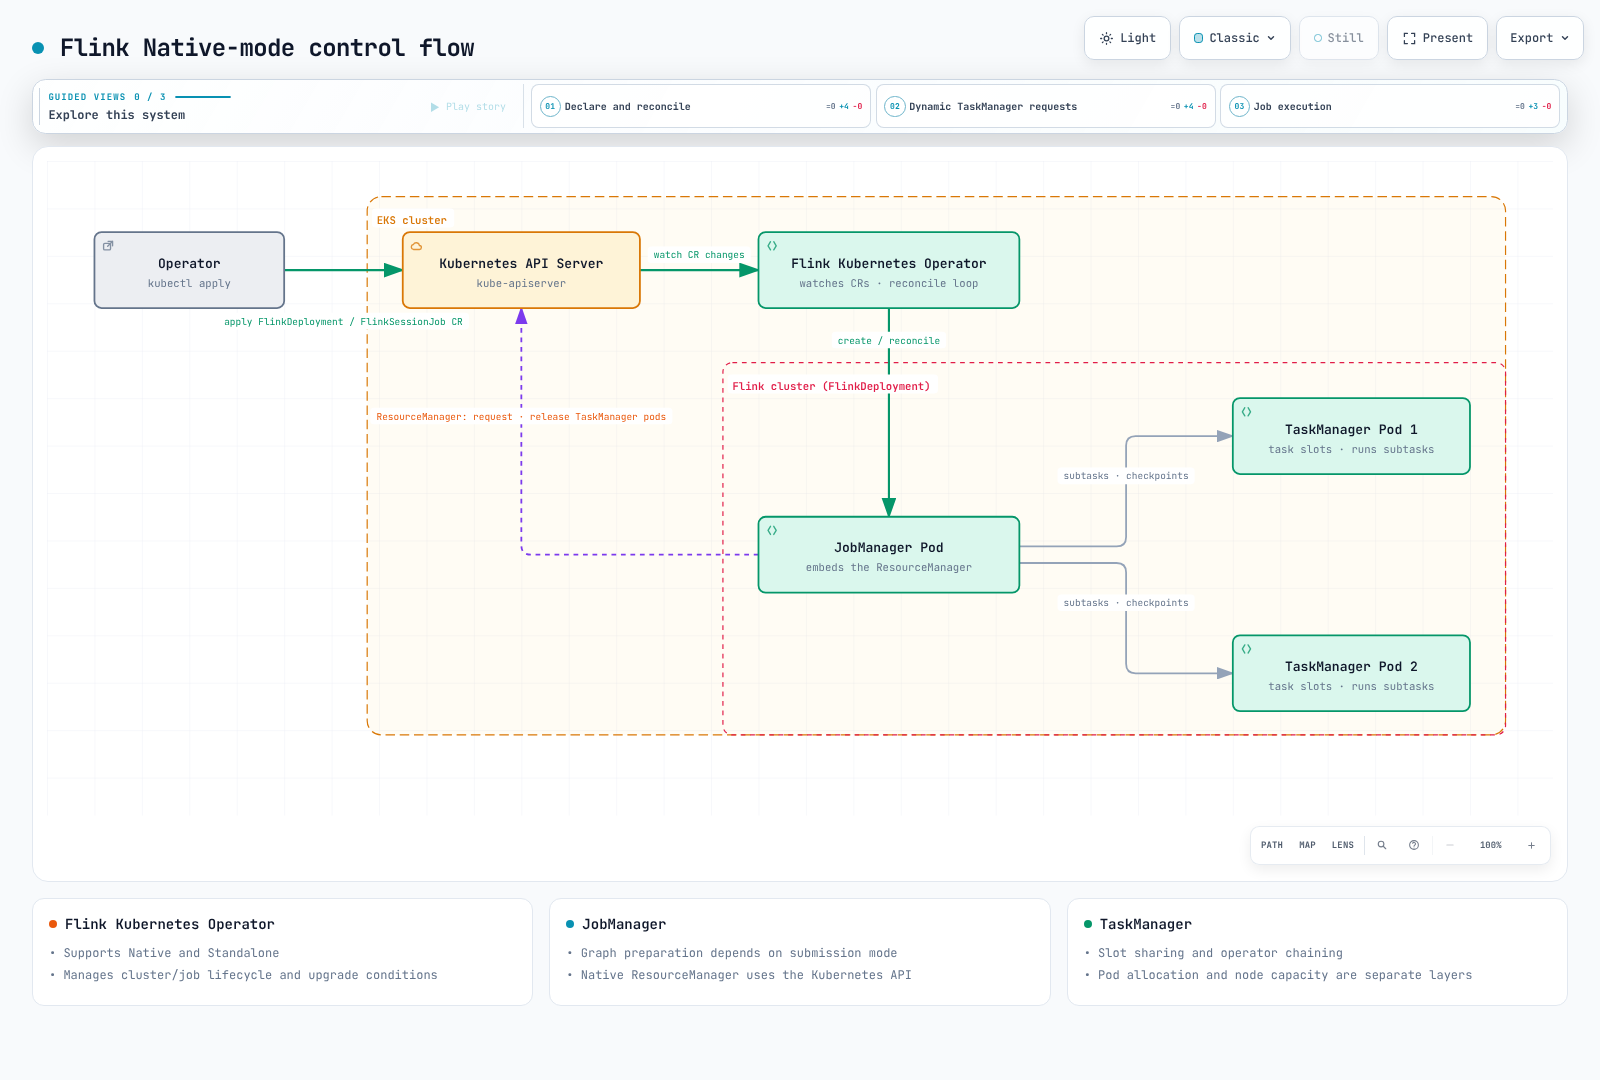
- Operator 协调集群/作业生命周期,并支持 Native 和 Standalone 两种模式。
- 在 Native 模式下,JobManager 的 Kubernetes ResourceManager 会请求/释放 TaskManager Pod。在 Standalone 模式下,Operator 等外部管理器负责管理 Kubernetes 资源。
- Task slot 既不等同于 CPU 核,也不严格对应一个算子子任务。算子链和 slot 共享可能让多个算子位于一个 slot 中;应分别评估状态、内存和 CPU。
下图展示的是 Native 模式下的逻辑控制流。Pod 的释放取决于空闲超时、容量需求和清理策略;作业完成后,节点成本不会立即消失。
各章节
- 架构:进程/slot 共享,以及 Application/Session 与 Native/Standalone 两组维度。
- Flink Kubernetes Operator:CRD、安装、升级和自动扩缩容。
- 状态、检查点和流处理:后端、恢复和连接器的实际保证。
- 运维和高可用:指标、高可用存储、节点容量和托管服务比较。
本指南以通过 Operator 进行声明式管理为主;CLI 示例用于解释其下层运行时。不使用 Operator 也是受支持的选择。