Grafana 仪表板
支持的版本:Grafana 13.2.1 · 社区 Helm chart 13.2.2
最后更新:September 13, 2026
简介
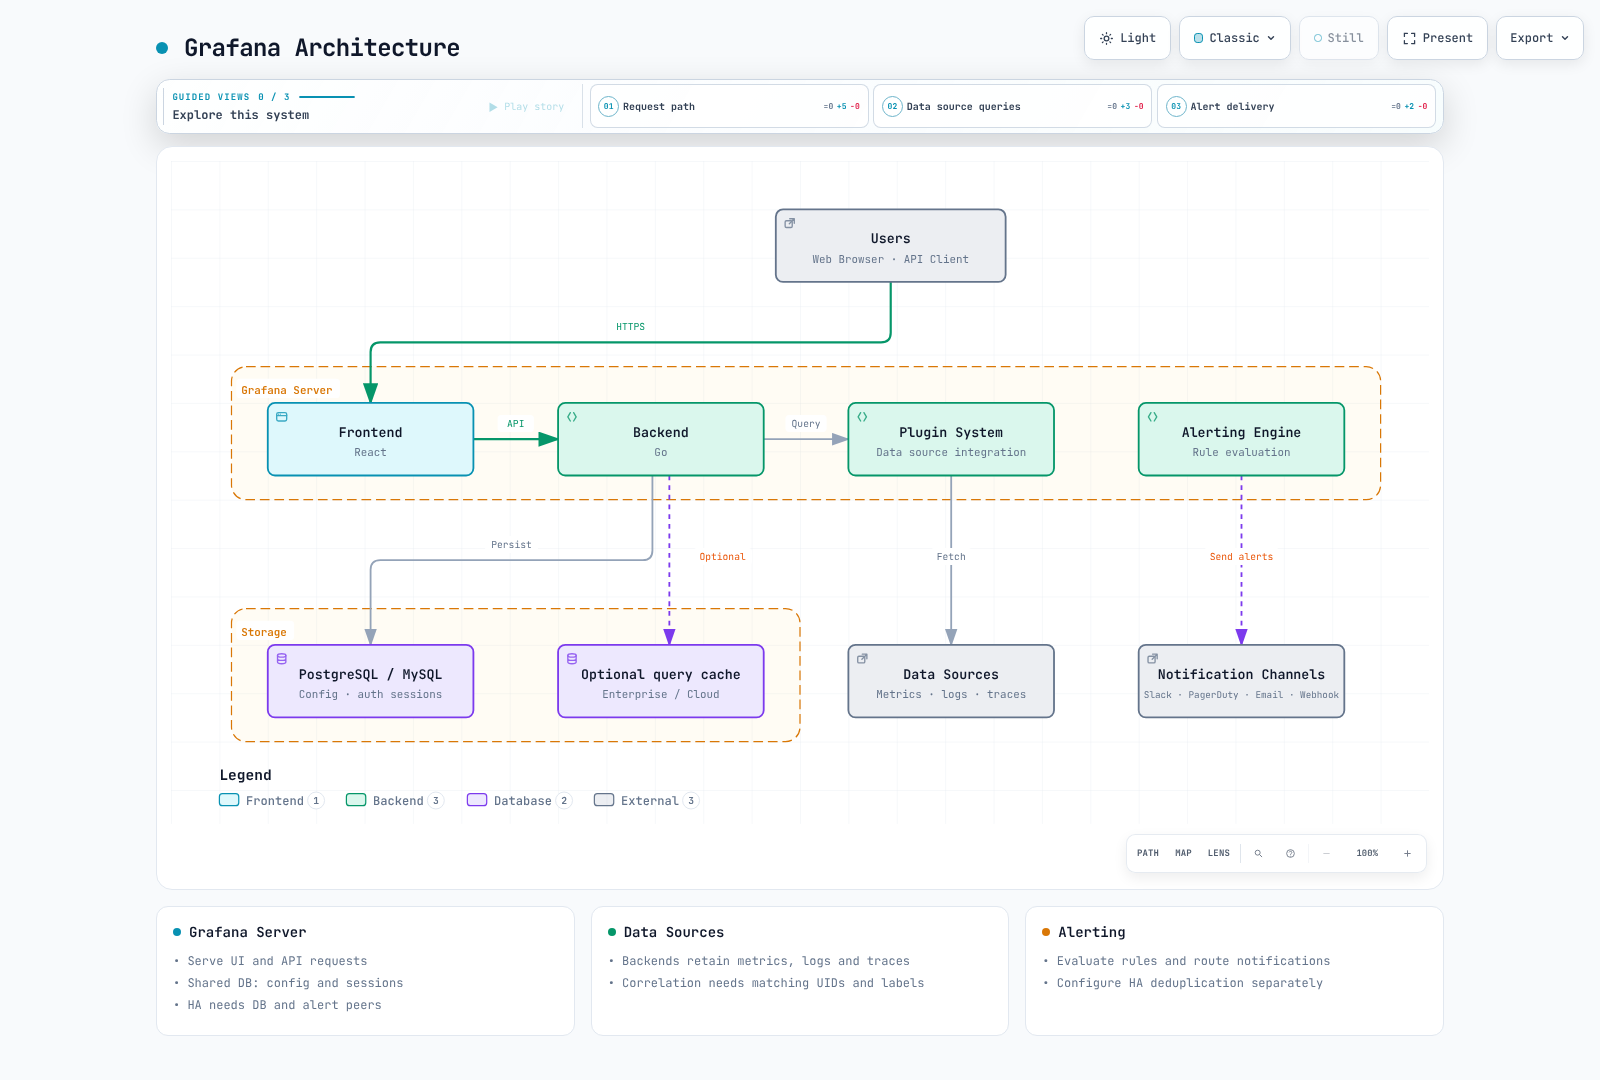
Grafana 查询 Prometheus、Loki、Tempo、CloudWatch 和其他数据源,并提供仪表板和告警功能。其元数据数据库与保留指标、日志和追踪数据的后端相互独立。可运行示例会连接到一个集群中现有的后端。有关后端部署,请参阅可观测性堆栈实验。
架构
| 组件 | 职责 |
|---|---|
| Grafana 数据库 | 用户、仪表板、配置和身份验证会话;用于 HA 的共享 PostgreSQL/MySQL |
| 数据源 | 实际的指标、日志和追踪查询及保留 |
| Grafana Alerting | 评估和通知路由;通知去重需要单独的 HA 配置 |
| 可选查询缓存 | Enterprise/Cloud 支持的功能;Redis 不是必需的会话存储 |
Helm 部署
基础安装
默认配置文件使用一个副本、SQLite、一个 RWO PVC 和 Recreate 更新策略。它需要 gp3 StorageClass 和 CSI driver,并且在升级期间可能不可用。HA 是独立的配置文件。chart 来自社区仓库;其版本和镜像摘要均已固定。
检出此仓库并编辑 endpoints.yaml 中的所有三个 URL,使其与实际的 Service 和端口相匹配。Tempo 3.x 示例使用 HTTP API 端口 3200,该端口不同于 OTLP 接收端口。占位 Service 名称不会创建后端。如果实验后端需要 mTLS,请将其 CA/client certificate 配置添加到数据源;纯 HTTP 无法绕过它。
这些命令适用于新安装。对于现有凭证,请通过既定流程进行轮换,而不是覆盖 Secret。登录时请在本地读取生成的私有密码文件;不要将其内容保存在 Git、values 文件或终端日志中。
helm repo add grafana-community https://grafana-community.github.io/helm-charts
helm repo update grafana-community
kubectl create namespace monitoring --dry-run=client -o yaml | kubectl apply -f -
cd examples/observability/grafana

umask 077
GRAFANA_STATE=$(mktemp -d "$PWD/.grafana-private.XXXXXX")
printf '%s' admin > "$GRAFANA_STATE/admin-user"
python3 -c 'import secrets; print(secrets.token_hex(24), end="")' > "$GRAFANA_STATE/admin-password"
python3 -c 'import secrets; print(secrets.token_hex(32), end="")' > "$GRAFANA_STATE/secret-key"
python3 -c 'import secrets; print(secrets.token_hex(24), end="")' > "$GRAFANA_STATE/metrics-password"
kubectl -n monitoring create secret generic grafana-admin-credentials \
  --from-file=admin-user="$GRAFANA_STATE/admin-user" \
  --from-file=admin-password="$GRAFANA_STATE/admin-password"
kubectl -n monitoring create secret generic grafana-runtime \
  --from-file=secret-key="$GRAFANA_STATE/secret-key" \
  --from-file=metrics-password="$GRAFANA_STATE/metrics-password"

kubectl apply -f endpoints.yaml
kubectl -n monitoring create configmap grafana-datasources --from-file=datasources.yaml
kubectl -n monitoring create configmap grafana-alerts --from-file=alerts.yaml
kubectl -n monitoring create configmap grafana-docs-dashboards --from-file=dashboard.json
helm upgrade --install grafana grafana-community/grafana --version 13.2.2 \
  --namespace monitoring --values values.yaml --wait
kubectl -n monitoring port-forward service/grafana 3000:80 --address 127.0.0.1
打开 http://localhost:3000。该 Service 是 ClusterIP,且端口转发仅绑定到回环地址。暴露 Grafana 之前,请配置身份验证、TLS 以及已批准的网络/访问策略。
values.yaml 配置
replicas: 1
deploymentStrategy:
  type: Recreate
persistence:
  enabled: true
  type: pvc
  storageClassName: gp3
  size: 10Gi
  accessModes:
  - ReadWriteOnce
admin:
  existingSecret: grafana-admin-credentials
  userKey: admin-user
  passwordKey: admin-password
serviceAccount:
  create: true
  name: grafana
  automountServiceAccountToken: false
完整文件连接 Secret 挂载、固定的数据源 UID、仪表板文件和已暂停的告警。对于挂载的 ConfigMap 预配,更新文件后请按顺序重启 Pod,以便再次运行预配。请显式提供每个预期的 values 文件,而不是使用 --reuse-values 保留未知的历史设置。
高可用性
values-ha.yaml 添加两个副本,禁用共享 PVC,并配置使用 verify-full 的外部 PostgreSQL、一个 headless Service 以及 Alerting gossip。请单独准备数据库 HA、备份和恢复。不要在 Grafana 副本之间共享一个 SQLite 文件。
示例数据库/用户为 grafana。准备一个包含 host(与证书匹配的 DNS:5432)、password 和 ca.crt 的 grafana-database Secret;在两个 Pod 上挂载相同的 grafana-runtime/secret-key。将 root_url 替换为真实的外部 HTTPS 地址并配置 TLS 终止。迁移现有 SQLite 数据需要单独进行迁移和恢复检查;更改数据库类型不会迁移数据。
helm upgrade --install grafana grafana-community/grafana --version 13.2.2 \
  -n monitoring -f values.yaml -f values-ha.yaml --wait
Peer DNS 假设 release 为 grafana 且 namespace 为 monitoring;若任一项发生变化,请进行更新。允许 Grafana Pod 之间的 TCP/UDP 9094 流量,以及仅允许所需的 DNS、数据库和后端连接。身份验证会话存储在共享的 Grafana 数据库中,因此不需要 Redis 会话或 load-balancer 亲和性来维持登录连续性。
Alerting HA 需要 Peer 连通性和去重配置。请考虑在默认配置下每个节点都会进行评估。版本 13.2.1 也具有 ha_single_node_evaluation,但此示例保留其默认值。在网络分区情况下,去重并不保证通知恰好一次送达。原生验证使用了一个 Grafana 实例,未对此 HA 配置文件执行数据库故障转移。
数据源集成
文件预配和 UID
datasources.yaml 固定了 Prometheus=prometheus、Loki=loki 和 Tempo=tempo。仪表板、告警和关联链接必须使用匹配的 UID。环境变量在预配文件中提供值;仅设置变量不会创建数据源对象。
apiVersion: 1
datasources:
- name: Prometheus
  type: prometheus
  uid: prometheus
  url: $PROMETHEUS_URL
  access: proxy
  isDefault: true
  editable: false
  jsonData:
    httpMethod: POST
    exemplarTraceIdDestinations:
    - name: trace_id
      datasourceUid: tempo
- name: Loki
  type: loki
  uid: loki
  url: $LOKI_URL
  access: proxy
  editable: false
  jsonData:
    derivedFields:
    - name: TraceID
      matcherRegex: '"trace_id"\s*:\s*"([a-f0-9]{32})"'
      url: $${__value.raw}
      datasourceUid: tempo
- name: Tempo
  type: tempo
  uid: tempo
  url: $TEMPO_URL
  access: proxy
  editable: false
  jsonData:
    tracesToLogsV2:
      datasourceUid: loki
      tags:
      - key: service.name
        value: service_name
      spanStartTimeShift: -5m
      spanEndTimeShift: 5m
      customQuery: true
      query: '{$${__tags}} | json | trace_id="$${__span.traceId}"'
    tracesToMetrics:
      datasourceUid: prometheus
      tags:
      - key: service.name
        value: service
      queries:
      - name: Request rate
        query: sum(rate(lab_http_requests_total{$${__tags}}[5m]))
    serviceMap:
      datasourceUid: prometheus
    nodeGraph:
      enabled: true
这些链接使用实验应用程序的 service.name、Loki 的 service_name、指标标签 service 和 JSON 日志字段 trace_id。请针对其他流水线调整为实际标签。$${...} 会在文件预配过程中保留 Grafana 的 ${...} 链接宏。${__tags} 展开为如 service="..." 的匹配器;再次将它包裹在 service="${__tags}" 中会创建无效的 selector。
Exemplar 将选定的指标观测值连接到追踪;它们不包含每个请求的追踪。Exporter 支持、Prometheus Exemplar 摄取和追踪保留必须保持一致。serviceMap 需要 Prometheus 中来自 Tempo metrics-generator 的服务图指标。仅配置 UID 不会生成服务图。
CloudWatch IRSA
将已批准的 IRSA role 附加到 Grafana 的 ServiceAccount,并将其 OIDC trust 限制为精确的 namespace/ServiceAccount 和 aud。在 Pod 中验证 token 投影和 SDK 凭证获取。数据源 authType: default 使用该凭证链。不要将 assumeRoleArn 冗余地设置为同一 role;应将其用于经过审慎考虑的额外 role 假设,并配置必要的 trust 和 sts:AssumeRole 权限。
指标查询从 cloudwatch:ListMetrics 和 cloudwatch:GetMetricData 开始。仅在使用相应功能时添加 Logs、EC2、tag 或 X-Ray 权限。对于不支持资源级权限的操作,请使用适用的 Region 条件约束 Resource: "*";将 Logs 访问范围限定到实际日志组。不要在一条无条件通配符语句中组合所有 AWS 读取操作。默认示例不会创建 AWS 凭证或资源。
仪表板设计模式
dashboard.json 是包含八个面板的完整 JSON。应用程序面板使用来自 MSA 实验的 lab_http_*。节点面板需要 node-exporter;CrashLoop 面板需要 kube-state-metrics。
| 方法 | 信号 | 解读 |
|---|---|---|
| RED:速率、错误、时长 | 请求速率、5xx 百分比、直方图 p99 | 不要将缺失或零请求流量视为 100% 成功 |
| USE:利用率、饱和度、错误 | CPU/内存使用、磁盘队列压力、网络错误 | 加权 I/O 时间不是磁盘错误计数器 |
| 四个黄金信号 | 延迟、流量、错误、饱和度 | 可用性是一个重要且独立的 SLI,不是这四个名称之一 |
只有在对应请求序列存在时,才以零填充缺失的错误序列:
((sum by (service) (rate(lab_http_requests_total{status=~"5.."}[5m])) or 0 * sum by (service) (rate(lab_http_requests_total[5m]))) / (sum by (service) (rate(lab_http_requests_total[5m])) > 0)) * 100分母排除了零流量。请分别显示缺失的采集和无流量。rate(node_disk_io_time_weighted_seconds_total[5m]) 估算平均 I/O 队列压力;increase(...) 不会统计磁盘错误。node_load1 包含可运行任务和 I/O 等待,并非 CPU 饱和度的纯度量。
该仪表板假定只有一个集群。将多个集群组合到一个中央后端时,请一致地附加 cluster 标签,并在 selector、分组和 join 中包含它们。Pod 指标 join 至少需要 namespace 和 pod。仅当这些标签存在时才添加 cluster/namespace 变量。多选/全选需要正则匹配器和 ${variable:regex} 转义。变量和文件夹不是数据源访问控制。
仪表板预配
Sidecar
默认的挂载文件配置文件不需要 Kubernetes API token/RBAC。当需要动态监视 ConfigMap 时,添加 values-sidecar.yaml。此可选配置文件使用 namespace 范围的 Role,只读取 monitoring 中的 ConfigMap,并选择 grafana_dashboard: "true"。该标签/值可配置,并非通用的 Grafana 要求。任何能够写入匹配 ConfigMap 的人都可以更改预配内容。
chart 的默认 namespace 范围 Role 也读取 Secret。请先在 sidecar-role.yaml 中创建仅限 ConfigMap 的 Role,并通过 useExistingRole 引用它。
kubectl apply -f sidecar-role.yaml
helm upgrade grafana grafana-community/grafana --version 13.2.2 \
  -n monitoring -f values.yaml -f values-sidecar.yaml
此 provider 使用单独的 Sidecar 文件夹;数据源和告警 Sidecar 仍保持禁用。不要将 searchNamespace: ALL 和广泛的 Secret 访问权限复制为常规默认设置。要保留对只读预配仪表板的更改,请更新其源文件。
Grafana Operator
Operator 部署首先需要匹配的 controller/CRD,以及一个由其 GrafanaDashboard/GrafanaDatasource 资源选择的 Grafana 实例。不要让单独的 Helm 部署和 Operator 争夺所有权。本章验证 Helm 文件预配,而非 Operator 安装。panels: [...] 等省略号不是有效的可部署 JSON;请使用完整的 dashboard.json 作为仪表板内容。
告警规则(Grafana Alerting)
在 13.2.1 中使用 [unified_alerting];不要启用已移除的旧版 [alerting] 配置。该示例通过 A=CPU 范围查询、B=last 归约和 C=>80 阈值保留标签。需要多维告警标签时,classic_conditions 并不适用。
apiVersion: 1
groups:
- orgId: 1
  name: grafana-docs
  folder: Observability
  interval: 1m
  rules:
  - uid: docs-high-cpu
    title: Sustained CPU usage
    condition: C
    data:
    - refId: A
      relativeTimeRange:
        from: 300
        to: 0
      datasourceUid: prometheus
      model:
        refId: A
        expr: 100 * (1 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m])))
        instant: false
        range: true
        intervalMs: 15000
        maxDataPoints: 43200
    - refId: B
      relativeTimeRange:
        from: 0
        to: 0
      datasourceUid: __expr__
      model:
        refId: B
        type: reduce
        expression: A
        reducer: last
    - refId: C
      relativeTimeRange:
        from: 0
        to: 0
      datasourceUid: __expr__
      model:
        refId: C
        type: threshold
        expression: B
        conditions:
        - type: query
          evaluator:
            type: gt
            params:
            - 80
          operator:
            type: and
          query:
            params:
            - C
          reducer:
            type: last
            params: []
    noDataState: NoData
    execErrState: Error
    for: 5m
    isPaused: true
    annotations:
      summary: High CPU on {{ $labels.instance }}
    labels:
severity: warning该规则以暂停状态安装。取消暂停之前,请验证真实数据、评估结果、通知策略和联系人。for: 5m 是等待时长;interval: 1m 是评估频率。不要将 NoData/Error 隐藏为正常状态。频繁重启并不能证明容器当前处于 CrashLoopBackOff;请使用该状态对应的 waiting-reason 指标。
使用文档化的 schema 和来自 Secret 的值预配 Slack/PagerDuty 联系人。使用内置通知模板,或在引用自定义模板前显式定义它;如 slack.title 等未定义的名称会失败。仅有 contact point 并不能建立路由:请将 receiver 附加到 notification policy。仅向已批准的目的地发送真实测试。本次审计未发送外部通知。
Grafana 自身指标
/metrics 使用单独的 basic authentication。安装 Prometheus Operator,并使 ServiceMonitor 的 release 标签与其 selector 匹配。该密码必须与 Grafana 挂载的密码相匹配:
printf '%s' metrics > "$GRAFANA_STATE/metrics-user"
kubectl -n monitoring create secret generic grafana-metrics-auth \
  --from-file=username="$GRAFANA_STATE/metrics-user" \
  --from-file=password="$GRAFANA_STATE/metrics-password"
helm upgrade grafana grafana-community/grafana --version 13.2.2 \
  -n monitoring -f values.yaml -f values-metrics.yaml
身份验证和访问
确认外部 HTTPS、IdP callback(/login/generic_oauth)、实际 endpoint/JWKS 和 group claim 后,将此 INI 片段映射到 chart 的 grafana.ini.auth.generic_oauth。单独添加 OAuth Secret 文件挂载。这些占位 IdP endpoint 并非可直接运行的 SSO 安装。
[auth.generic_oauth]
enabled = true
name = Organization SSO
client_id = $__file{/run/grafana-oauth/client-id}
client_secret = $__file{/run/grafana-oauth/client-secret}
scopes = openid profile email groups
auth_url = https://sso.example.com/authorize
token_url = https://sso.example.com/token
api_url = https://sso.example.com/userinfo
use_pkce = true
validate_id_token = true
jwk_set_url = https://sso.example.com/actual-jwks-endpoint
role_attribute_strict = true
allow_assign_grafana_admin = false
role_attribute_path = contains(groups[*], 'grafana-admins') && 'Admin' || contains(groups[*], 'grafana-viewers') && 'Viewer'
allow_sign_up = true
Admin 是 organization role,与 server-level GrafanaAdmin 不同。严格映射会拒绝映射组以外的用户;PKCE 和 ID-token 签名验证均已启用。请在目标环境中验证实际登录、组变更和撤销。Viewer 可以查询其 organization 中的数据源,范围超出可见仪表板上的查询,因此仅靠文件夹权限无法限制底层数据访问。
Grafana Cloud 与自托管对比
| 领域 | 自托管 OSS | Grafana Cloud |
|---|---|---|
| 运维 | 自行管理 DB、升级、备份和容量 | 托管服务;请检查合同和限制 |
| 可用性 | 自行设计并验证 | SLA 取决于实际计划/服务协议 |
| 数据源权限/查询缓存 | 不要假定这些是 OSS 功能 | 检查支持的能力和计划 |
| 数据位置 | 所选的基础设施/后端 | 实际 stack Region、保留和处理条款 |
| 插件 | 验证兼容性、签名和打包 | 支持的目录和 stack 策略 |
从 stack 的 Connections 页面获取 Cloud Prometheus/Loki URL 和用户名。不要假定 ID 相同,也不要复制虚构的区域 URL。使用限定为所需 metrics:read/logs:read 访问权限的 Cloud Access Policy token,并通过 Secret 提供 secureJsonData.basicAuthPassword。Grafana service-account token 和 Cloud 数据访问 token 用途不同。
最佳实践
按用途组织 Overview、Infrastructure、Kubernetes、Applications 和 Alerts。包含单位和缺失数据状态。在增加资源之前,先减少查询范围、频率和基数;对重复计算使用 recording rules。将已弃用的 Angular piechart/worldmap 插件替换为内置 Pie chart/Geomap 面板。固定兼容的附加插件,并向每个 HA 节点提供相同版本。
[dashboards] min_refresh_interval = 10s 限制浏览器刷新频率,而不是告警评估。根据 DB 连接限制和副本数量调整数据库连接池大小。OSS 的 [caching] enabled/ttl 片段不提供 Enterprise/Cloud 查询缓存。
验证范围和参考资料
已渲染单实例、HA、指标和 Sidecar chart 配置文件。一个实际的 Grafana 13.2.1 实例检查了数据源、仪表板、暂停的告警预配、表达式评估和指标身份验证。表达式使用了合成的 Prometheus 响应。这些检查未部署 EKS、未验证真实后端 TLS、未对 HA 数据库进行故障转移、未完成 SSO/IRSA,也未发送外部通知。
测验
通过 Grafana 测验测试配置和运维方面的差异。